对应 Maps to:MIT 6.S184 Generative AI with Stochastic Differential Equations(IAP 2026),Lecture 5 · 30-Jan-2026 · Discrete Diffusion Models(原课没有配套 Lab)。 阅读材料:原课讲义 Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(2026 版,arXiv:2506.02070)第 7 章与附录 C;Lecture 5 slides;原始论文 Campbell et al. (2022) A Continuous Time Framework for Discrete Denoising Models、Campbell et al. (2024) Discrete Flow Models、Gat et al. (2024) Discrete Flow Matching、Sahoo et al. (2024) MDLM、Shi et al. (2024) MD4、Ou et al. (2024) RADD、Nie et al. (2025) LLaDA、Holderrieth et al. (2025) Generator Matching。 依据说明:本讲以原课讲义第 7 章为主线:连续时间马尔可夫链与速率矩阵、分解 CTMC 与 Algorithm 7、Kolmogorov 前向方程、离散流匹配(条件路径、条件速率、边缘化技巧)、分解混合路径、掩码扩散语言模型与 Algorithm 8、扩散语言模型和自回归模型的比较、生成器匹配。“两状态链的欧拉误差""掩码链在线性调度下欧拉法精确""全状态空间上逐条检验边缘化技巧""用精确后验分离并行解码误差""ELBO 按掩码个数分层""同规模 MDLM vs AR”等实验,以及玩具语言本身,是本讲义补充的。其中有几处结果与我原先的预期不一致(§5.2 的置信度优先、§4.5 的似然差距分布),如实报告。 配套代码 Code:
code/lecture06/(4 个脚本 + 3 个模块;PyTorch + matplotlib;每个脚本 2–75 秒,都完整运行过) 预计阅读时间:5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清连续时间马尔可夫链(CTMC)是什么:速率矩阵的两条规则、""的欧拉采样、停留时间为什么是指数分布;把它和 ODE / SDE 逐项对照。
- 写出 Kolmogorov 前向方程 ,把它读成”流入 − 流出”,认出它是连续性方程的离散版。
- 理解序列上为什么要用分解的 CTMC(一次只改一个 token),以及分解欧拉采样(Algorithm 7)在同一步里独立地处理每个位置。
- 按第 2 讲的四步搭出离散流匹配:分解混合路径、条件速率 、离散边缘化技巧、交叉熵损失(Algorithm 8)。
- 解释掩码扩散语言模型的几个关键性质:后验与 无关、ELBO 等于”随机顺序自回归”的似然、并行解码的误差从哪来;比较它和自回归语言模型的优劣。
- 用生成器的语言把 ODE、SDE、CTMC 统一起来。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 条件 / 边缘概率路径、边缘化技巧、连续性方程 | 第 2 讲 §2–§3 |
| 条件流匹配损失(定理 12);“回归的最优解是条件期望” | 第 2 讲 §4、P1 §4.2 |
| 损失的加权不改变最优解、只改变有限容量时的取舍 | 第 3 讲 §2.4 |
| Transformer 的自注意力、因果掩码 | 第 5 讲 §2.2;本仓库 CMU10-423 |
| 交叉熵、KL 散度 | 前置讲 P1 §2 |
本讲不讲 D3PM(离散时间的转移矩阵)和 SEDD(“具体得分”、得分熵损失)的细节,只在 §6 和延伸阅读里点到。
0.3 本讲地图 Map
§1  连续时间马尔可夫链:速率矩阵、两状态链、停留时间、欧拉法          ← 代码 01
§2  Kolmogorov 前向方程:流入 − 流出                                  ← 代码 02 第 1 部分
§3  离散流匹配:分解 CTMC、混合路径、条件速率、边缘化技巧            ← 代码 02 第 2–3 部分
§4  训练:交叉熵、掩码扩散、后验与 t 无关、ELBO、MDLM vs AR           ← 代码 03 第 2、4 部分;代码 04
§5  采样:并行解码的误差、揭开的顺序、掩码 vs 均匀、扩散 vs 自回归    ← 代码 03 第 3 部分;代码 04
§6  生成器匹配:ODE、SDE、CTMC 的统一
§7  小结   §8  常见误区   §9  练习   §10 延伸阅读   §11 下一讲预告
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 有限的状态空间。序列的情形 :词表 (大小 ),长度 | |
速率矩阵: 时刻从 跳到 的速率。代码里存成矩阵 Q[x, y],每行和为 0 | |
| 时为 1,否则为 0 | |
| , | 序列 的第 个 token;除第 个以外的所有 token |
| 混合路径的调度:一个 token “已经是答案”的概率,,;本讲默认 | |
| 条件速率的大小; 时发散 | |
| 掩码 token [MASK] | |
| 后验:在 的条件下,数据的第 个 token 是 的概率;网络学的就是它 |
玩具语言。本讲的实验都在一个代码定义的小语言上做(toy_language.py):
冠词 [形容词] 名词 动词 冠词 [形容词] 名词 . ( _ _ ) 例:two big cats chase a small dog .规则:R1 “a” 只接单数、“two” 只接复数;R2 主谓一致;R3 宾语和主语不能是同一种动物;形容词可有可无,所以句子 6–8 个 token,用 PAD(”_“)补到 8。词表 20 个 token,合法句子共 4608 个,每个的概率都能精确算出,分布的熵是 8.148 nats / 句。它的作用和前几讲的高斯混合一样:真相已知,可以把”模型学得不好”和”方法本身的误差”分开。
1. 连续时间马尔可夫链 · Continuous-time Markov chains
1.1 离散空间里没有”走一小步”
前五讲的机器是 ODE / SDE:粒子在 里沿向量场连续地移动。文字是一串 token,每个 token 是词表里的一个编号。“cat”和”dog”之间没有”走到一半”的地方,“cat + 0.01 × 速度”没有意义。
离散空间里唯一能做的运动是跳:此刻是 cat,下一刻变成 dog。于是问题变成:怎样描述”什么时候跳、跳到哪里”?答案是给每一对状态一个速率: 表示”在 的时候,单位时间内跳到 的倾向”。时间很短的 里,
这就是连续时间马尔可夫链(continuous-time Markov chain,CTMC)。速率矩阵扮演向量场的角色:向量场说”往哪个方向、以多快的速度走”,速率矩阵说”往哪个状态、以多大的速率跳”。
1.2 速率矩阵的两条规则
要让上式对任何小 都是一个概率分布, 必须满足:
- 非对角元非负:()。速率不能是负的。
- 每行和为 0:。对角元是负的, 是”离开 的总速率”,这保证 。
原课讲义的存在唯一性定理说:状态空间有限、速率矩阵随 连续时,给定初始分布,CTMC 存在而且唯一(直观上, 满足的是一个线性 ODE,§2)。
| 连续:ODE / SDE | 离散:CTMC |
|---|---|
| 向量场 | 速率矩阵 ,每行和为 0 |
| 欧拉一步: | 欧拉一步:从 里抽 |
| 流 / 转移核 | 转移矩阵 (时间齐次时 ) |
| 连续性方程 | Kolmogorov 前向方程 (§2) |
| 神经网络输出 个数 | 神经网络输出…… 个数?(§3 解决) |
1.3 最简单的例子:两状态链
状态 , 的速率 , 的速率 :
记 。在 里,状态 0 的粒子有 的比例跳到 1,状态 1 的粒子有 的比例跳回 0:
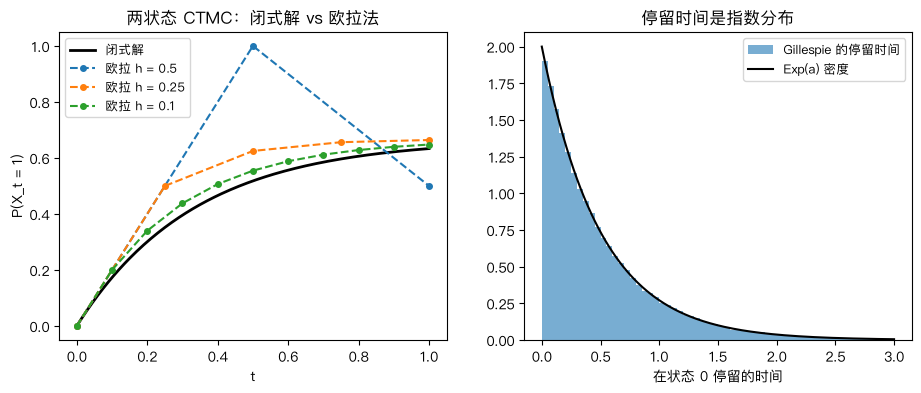
分布以速率 指数地趋向平稳分布 。01 号脚本取 、、从 0 出发,看 时 :
| 方法 | 与闭式解之差 | |
|---|---|---|
| 闭式解 | 0.63348 | — |
| 矩阵指数 | 0.63348 | |
| Gillespie 精确模拟(10 万个粒子) | 0.63067 | (两个标准误是 ) |
| 欧拉 (2 步) | 0.50000 | 0.13 |
| 欧拉 (10 步) | 0.64783 | 0.014 |
| 欧拉 (100 步) | 0.63496 | 0.0015 |
欧拉法的误差随 线性下降,和 ODE 的欧拉法一样是一阶方法。
1.4 另一种看法:等多久、跳到哪
“每一小段时间 里以概率 跳走”意味着:在状态 停留的时间服从指数分布 ,;离开时,按 的比例选择去哪个 。指数分布是唯一”无记忆”的连续分布——已经等了多久,不影响接下来多久会跳。
这给出一个没有离散误差的模拟方法(Gillespie 算法):抽等待时间、跳、再抽等待时间……01 号脚本里,从状态 0 出发的第一次停留时间的样本均值 0.5015、标准差 0.5025,和 的 (均值和标准差相等)一致;直方图和密度 逐格吻合(图)。
Gillespie 算法只适合状态少的链。生成模型里状态空间是 、速率随 变化,实践中都用欧拉法。
1.5 欧拉法的步长限制
的对角元 在 时是负的。01 号脚本第 2 部分:、 时”留在 0 的概率”是 ,根本没法抽样。连续的欧拉法步长太大时只是不准;离散的欧拉法步长太大时直接失效。精确的转移 对任何 都合法。
这个限制在扩散语言模型里会碰到:§3.3 的条件速率 在 时发散。好在对线性调度 ,最后一步 时 ,恰好卡在边界上:剩下的所有位置在最后一步一次性确定。
2. Kolmogorov 前向方程 · The Kolmogorov forward equation
2.1 推导:流入 − 流出
记 。由 §1.1,
令 :
这就是 Kolmogorov 前向方程(Kolmogorov forward equation,KFE)。把对角项拆出来:
一个状态上概率的变化 = 流进来的 − 流出去的。第 2 讲的连续性方程 说的是同一句话:密度的变化等于概率流 的净流入。两者的唯一区别是”流”沿着连续的方向还是沿着离散的边。
和连续情况一样,我们说速率矩阵 生成概率路径 ,当且仅当 满足 KFE。第 2 讲的整个逻辑——“找一个生成目标路径的向量场”——在这里变成”找一个生成目标路径的速率矩阵”。
2.2 数值检验
02 号脚本第 1 部分取一个随时间变化的 3 状态速率矩阵( 的速率随 变大、 的速率随 变小等),从状态 0 出发,用 RK4 解 KFE,再用 10 万个粒子做欧拉模拟():
| 时刻 | KFE 的解(状态 0 / 1 / 2) | 粒子 | 最大差 | 两个标准误 |
|---|---|---|---|---|
| 0.6578 / 0.2067 / 0.1356 | 0.6554 / 0.2080 / 0.1366 | 0.0024 | 0.0030 | |
| 0.4206 / 0.3414 / 0.2381 | 0.4224 / 0.3389 / 0.2387 | 0.0025 | 0.0031 | |
| 0.2306 / 0.5397 / 0.2297 | 0.2317 / 0.5388 / 0.2296 | 0.0011 | 0.0032 |
时,数值微分 ,和 逐项相同;拆开是流入 减去流出 。状态 0 流出得多、流入得少,概率在下降。
3. 离散流匹配 · Discrete flow matching
3.1 序列:为什么要”一次只改一个 token”
语言模型的状态空间是 。词表 万、长度 时, 是天文数字。一个通用的速率矩阵有 个元素,网络不可能输出它。
解决办法是限制跳的方式:一次只改一个 token。只有当 和 至多在一个位置不同时,速率才可能非零:
这叫分解的(factorized)速率矩阵。网络只需对每个位置 输出”这个位置跳到每个 token 的速率” ,共 个数——和网络对每个位置输出一个 维的 logits 完全一样。注意 依赖于整个序列 (这样才能表达 token 之间的关系),只是每次只改一个位置。02 号脚本里的小例子(、),掩码路径的全状态空间有 16 个状态,速率矩阵每行最多 6 个非零的非对角元(全连接是 15 个);规模越大,这个比例越悬殊( 对 )。
采样:Algorithm 7(原课讲义的分解欧拉法)。每一步对每个位置独立地抽:
严格地说,分解速率矩阵下”两个位置同时跳”的概率是 ;按位置独立地抽样,同一步里两个位置同时改变的概率也是 ,两者只差高阶小量, 时一致。但在有限步数下,这个”同时改变、彼此独立”会造成真实的误差,它是 §5.1 的主角。
3.2 四步走:照搬第 2 讲
第 2 讲构造流匹配用了四步,离散版本一步一步对应:
| 连续(第 2 讲) | 离散(本讲) | |
|---|---|---|
| 1. 条件路径 | 分解混合路径 | |
| 2. 条件”场” | ,生成 | 条件速率 ,生成 |
| 3. 边缘化技巧 | ||
| 4. 训练 | 对条件向量场做回归(均方误差) | 学后验 (交叉熵,§4) |
3.3 分解混合路径与条件速率
条件路径。给定数据 ,每个位置独立地:以概率 “已经是答案” ,否则是一个来自 的噪声 token:
时全是噪声, 时全是数据。两种常用的 :
- 掩码(mask,也叫 absorbing):。噪声 token 就是 [MASK],“看得出哪些位置还没生成”。
- 均匀(uniform): 是词表上的均匀分布。噪声 token 和真 token 长得一样。
03 号脚本第 1 部分对 = “two big cats chase a small dog .” 各抽一个 :
掩码  t = 0.25   two ■ cats ■ ■ ■ ■ .
掩码  t = 0.75   two big ■ ■ a small dog .
均匀  t = 0.25   two see cats like two dogs see .
均匀  t = 0.75   two big chases bird a small dog .
掩码路径里已经出现的 token 一定是对的;均匀路径里”chases”可能是真的,也可能是碰巧抽到的噪声。
条件速率。对单个位置,
直觉:还不是答案的位置,以速率 直接跳到答案;已经是答案的位置不动( 时两项抵消)。这和 CondOT 的条件向量场”直线奔向 “如出一辙。它满足速率矩阵的规则:非对角元只有 一项,值 ;每行和为 0。
它生成条件路径。单个位置:
正是 。各位置独立,所以分解的条件速率生成整个序列的条件路径。
为什么要发散。 时剩下的噪声 token 必须全部变成答案,剩余时间越少、跳得越急。对 ,“在 时刻还是噪声”的概率是 ,和 一致。01 号脚本第 3 部分还发现一件有用的事:线性调度下,单个位置的欧拉法是精确的—— 每步从 变成 ,正好是真值(任何步数,误差都是 0);换成余弦调度 ,2 / 4 / 16 步的最大误差是 0.29 / 0.13 / 0.029。所以在线性调度下,采样误差只可能来自 §3.1 说的”位置之间独立”。
3.4 离散边缘化技巧
定理(离散边缘化技巧)。设条件速率 生成条件路径 ,定义
则 生成边缘路径 。
证明(和第 2 讲 §3.4 逐字对应):
分解形式。代入混合路径的条件速率,对一个只在位置 和 不同的 :
边缘速率只需要一样东西:后验 ——“看到了 ,第 个位置的真 token 是什么”的概率分布。一个对每个位置输出 维 softmax 的网络,正好可以学它。欧拉一步因此变成一个很直观的规则:
每个位置以概率 从后验里重新抽一个 token,否则保持不变。掩码路径下,已揭开位置的后验就是它自己(掩码路径里出现的 token 一定是对的),所以只有 [MASK] 会变;均匀路径下任何位置都可能被改写。
逐条检验。02 号脚本第 2 部分在 、、、、、(两个位置强相关)上,把全状态空间的速率矩阵整个写出来,检验 KFE 的残差 :
| 检验 | 掩码路径 | 均匀路径 |
|---|---|---|
| (a) 条件速率 vs 条件路径 | ||
| (b) 后验加权的边缘速率 vs 边缘路径 | ||
| (c) 分解公式 vs 全矩阵公式 | ||
| (d) 按先验平均的速率 vs 边缘路径 | 0.10 / 0.40 / 1.60 | 0.10 / 0.40 / 1.60 |
(; 用中心差分,残差 就是”等于 0”。)
(d) 是一个常见的错误:忘了”给定当前状态 “,只按先验把条件速率平均。它相当于让每个位置按自己的边缘分布独立地生成——第 3 部分把两种速率都模拟到 ,按先验平均的速率最终分布和 的总变差距离(TV)始终约 0.54,步数再多也没用( 只能得到 ,而不是 0.4);按后验的边缘速率,64 步时 TV 降到 0.008(掩码)/ 0.016(均匀),抽样噪声的地板是 0.004。和连续情况一样:边缘向量场 / 速率是”给定当前位置的条件期望”,不是简单平均。
4. 训练:掩码扩散语言模型 · Training masked diffusion language models
4.1 学后验:交叉熵
网络 对每个位置输出一个 维的概率分布。损失是交叉熵:
为什么交叉熵的最优解是后验。固定 和位置 ,对 取期望:,在 时最小。这是第 2 讲”均方误差的最优解是条件期望”的离散版:均方误差 ↔ 条件期望,交叉熵 ↔ 条件分布。和第 2 讲的条件流匹配损失一样,我们只用到了条件的东西( 和 都是抽出来的),却学到了边缘速率需要的后验。
Algorithm 8(原课讲义,掩码版本;代码 dlm.train_mdlm):
Algorithm 8  训练掩码扩散语言模型
for 每一步:
    从数据集抽一批句子 z
    t ~ U[0, 1)
    每个位置独立地:以概率 κ_t 保留 z^i,否则换成 [MASK]     ← x ~ p_t(· | z)
    loss = 被掩码位置上的 −log p^θ(z^i | x) 的平均
    梯度下降一步
未掩码的位置不计入损失:掩码路径下它们的后验就是它们自己,没有可学的(对所有位置求和只多一个常数)。
4.2 掩码路径的后验与 无关
掩码路径下,
每个 [MASK] 位置贡献因子 ,对所有 都一样;每个已揭开的位置贡献 ,也只是”相容 / 不相容”。约掉常数后,——和 无关。
03 号脚本第 2 部分用精确后验验证: = “two ■ ■ ■ ■ ■ ■ ■”, 时后验完全相同(第 3 个位置是 cats 或 see 的概率都是 0.1667,是 sees 的概率为 0;第 8 个位置是 PAD 的概率 0.75),三个时刻之间全部 8 × 20 个概率的最大差 。
所以掩码扩散的网络不需要输入 —— 的信息已经包含在 [MASK] 的个数里了。MDLM、RADD 都指出了这一点,LLaDA 等大模型也不输入 。本讲的 TinyTransformer 就是一个普通的双向 Transformer。这还意味着: 就是”给定一部分 token,另一个 token 的条件分布”——和 BERT 的掩码语言模型学的东西一样,区别在于掩码比例要覆盖 0% 到 100% 的全部范围,而且要能用来生成。
均匀路径则不然。 = “two big cats sees the red dog .”(主谓不一致):
| 时刻 | P(第 4 个 = see) | P(第 4 个 = sees) | P(第 1 个 = two) |
|---|---|---|---|
| 0.266 | 0.150 | 0.685 | |
| 0.312 | 0.058 | 0.894 | |
| 0.332 | 0.003 | 0.994 |
越大越相信看到的 token;冲突靠”少数服从多数”解决:两个复数信号(two、cats)压倒一个单数信号(sees),后验认为 sees 是噪声,真正的动词是 see / like / chase 之一(各约 1/3)。网络必须知道 才能判断”一个 token 有多大可能是噪声”。
4.3 似然:ELBO 等于”随机顺序的自回归”
自回归模型能精确算出 (链式法则)。掩码扩散模型只有一个下界(ELBO;MDLM、MD4 的连续时间形式):
它可以化成一个很有启发的形式。按”恰好有 个位置被掩码”分组: 时,,给定 时被掩码集合是均匀随机的。记 = “恰好 个随机位置被掩码时,每个被掩码位置的平均 “。则
( 是 Beta 函数,推导见练习 4。)而 恰好是随机顺序自回归的期望负对数似然:随机排一个顺序 ,按顺序逐个预测 ;第 步时有 个位置还没揭开,被预测的是其中均匀随机的一个——平均起来正是 。
后验精确时 ELBO 是紧的:链式法则对每一种顺序都给出同一个 。03 号脚本第 4 部分枚举全部 255 个非空掩码集合(没有蒙特卡洛噪声),100 个句子上 ELBO 和真实 逐句的最大差是 。
加权。Algorithm 8 的”每个被掩码 token 权重相同”和 ELBO 的权重 不同。和第 3 讲 §2.4 一样:只要权重为正,最优解都是真实后验;权重只决定网络容量有限时”把精力放在哪些 上”。练习 6 比较了两种加权。
4.4 实验:同样大小的 MDLM 和自回归模型
04 号脚本用完全相同的 Transformer(3 层、宽 64、4 个头、153,300 个参数)训练两个语言模型,各 3000 步、批大小 256,在 CPU 上各约 35 秒:
- MDLM:双向注意力;输入部分被 [MASK] 的句子,输出每个位置的后验。
- AR:因果注意力;输入 [BOS] + 句子去掉最后一个词,输出”下一个词”的分布。
在 2000 个新抽的句子上(真实 的平均是 8.150 nats / 句):
| 模型 | 每句 nats | 比真值多 |
|---|---|---|
| 自回归:精确的 | 8.176 | 0.026 |
| 掩码扩散:ELBO(上界) | 8.242 | 0.092 |
MDLM 的上界比真值多 0.09 nats,约是 AR 的 3.5 倍。这和文献的经验一致:同规模的掩码扩散模型困惑度略差于自回归模型(MDLM、LLaDA 等论文都这样报告),但差距不大。
4.5 差距出在哪里?
按 拆开(1000 个句子,两列用同一组掩码):
| 掩码个数 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 合计 |
|---|---|---|---|---|---|---|---|---|---|
| 完美后验 | 0.685 | 0.713 | 0.764 | 0.848 | 0.954 | 1.107 | 1.332 | 1.789 | 8.192 |
| MDLM | 0.698 | 0.721 | 0.775 | 0.855 | 0.961 | 1.116 | 1.343 | 1.797 | 8.265 |
| 差 | +0.013 | +0.008 | +0.011 | +0.007 | +0.007 | +0.009 | +0.010 | +0.007 | +0.073 |
掩码越多越难( 是 的 2.6 倍:从一个 token 都没有开始猜,比只缺一个 token 难得多)。我原先猜 MDLM 的差距会集中在掩码多的地方,实际上它均匀地分布在每一个 上(每项多 0.007–0.013)。更合理的解释是:MDLM 要对 8 种掩码个数、每种的所有位置组合都学好条件分布,每一项都差一点,累加起来就是 0.07–0.09;AR 只需要学从左到右这一种顺序的 8 个条件分布。原课讲义的说法是”任意顺序更难学”——这个实验支持它,但差距的分布比我预想的更平均。
5. 采样与讨论 · Sampling and discussion
5.1 并行解码的误差
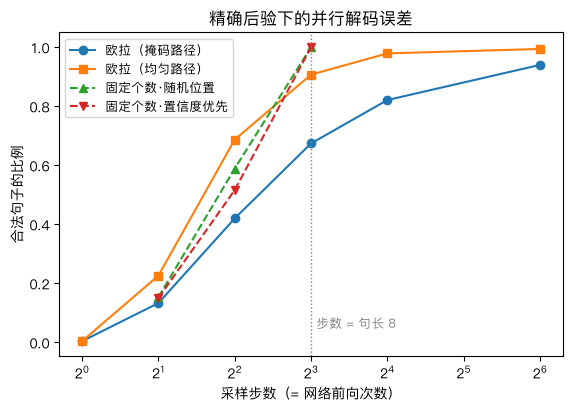
用精确后验采样,“模型学得不好”这一项就被排除了,剩下的全是采样方法本身的误差。03 号脚本第 3 部分,每种设置生成 1000 个句子:
| 采样方法 | 步数 = 前向次数 | 合法 | 不同句子 |
|---|---|---|---|
| 欧拉(掩码路径) | 1 | 0.4% | 999 |
| 欧拉(掩码路径) | 4 | 42.0% | 959 |
| 欧拉(掩码路径) | 8 | 67.4% | 909 |
| 欧拉(掩码路径) | 64 | 94.0% | 853 |
| 欧拉(均匀路径) | 4 | 68.7% | 929 |
| 欧拉(均匀路径) | 8 | 90.7% | 857 |
| 欧拉(均匀路径) | 64 | 99.4% | 843 |
| 固定个数·随机位置 | 4 | 58.9% | 938 |
| 固定个数·随机位置 | 8 | 100.0% | 819 |
(从真实分布抽 1000 个句子,平均约有 847 个不同的句子。)
为什么完美的后验也会生成错句。一步之内,各个位置独立地从各自的后验里抽 token。1 步时 8 个位置同时从全 [MASK] 出发,每个位置按自己的边缘分布抽:第 1 个位置抽到 “a”、第 3 个位置抽到 “cats”,各自都很合理,合起来就违反了 R1。98% 的错误是”结构错”——名词、动词、句号的位置对不上。这就是并行解码的误差(也叫”因子化误差”):后验 是边缘的,同一步里两个位置的选择本该相关,却被当成了独立的。
每步恰好揭开一个 = 精确。“固定个数”的采样让第 步结束时恰好揭开 个位置。8 步、句长 8 时每步恰好揭开一个,每个 token 都在看到之前所有 token 之后才抽——这就是随机顺序的自回归,生成的分布精确等于 ,合法率 100%。
欧拉法收敛得很慢。欧拉法每步揭开的个数是随机的:掩码路径下,同一步里同时揭开的”位置对”的期望个数是 (练习 5)。、64 步时约 0.44——即使平均每步揭开不到一个位置,也常常有某一步同时揭开两个,所以 64 步仍有 6% 不合法。速度是 ,和 ODE 的欧拉法一样慢。
5.2 揭开的顺序与个数
04 号脚本用训练好的 MDLM 做同样的事(AR 的合法率是 99.2%,8 次前向):
| 生成方式 | 前向次数 | 合法 | 不同句子 | 合法句子的平均 |
|---|---|---|---|---|
| 真实分布(参照) | — | 100.0% | 847 | 8.17 |
| 自回归(从左到右) | 8 | 99.2% | 874 | 8.24 |
| MDLM 欧拉 | 4 / 8 / 64 | 40.5% / 65.0% / 92.3% | 967 / 913 / 862 | 8.10 / 8.15 / 8.14 |
| MDLM 固定个数·随机位置 | 2 / 4 / 8 | 13.2% / 56.8% / 96.5% | 995 / 940 / 836 | 8.16 / 8.12 / 8.13 |
| MDLM 固定个数·置信度优先 | 2 / 4 / 8 | 20.7% / 42.5% / 96.8% | 975 / 913 / 827 | 7.99 / 7.86 / 8.04 |
几点观察:
- 网络误差 vs 并行解码误差。8 步(每步一个)时 MDLM 合法率约 97%,与完美后验(100%)的差距是网络误差。步数少于句长时并行解码误差占主导:4 步时 MDLM 与完美后验只差约 2 个百分点(欧拉 40.5% vs 42.0%,随机位置 56.8% vs 58.9%)。
- “每步揭开几个”比”走多少步”更关键。欧拉 64 步(92.3%)不如固定个数 8 步(96.5%):欧拉法多花的前向大多在”什么也没揭开”的步上(这些步的网络输出可以缓存,代码里也确实跳过了),同时揭开两个的风险却还在。
- 置信度优先(MaskGIT、LLaDA 等的做法:每步揭开后验最有把握的位置)。我原以为它会稳定地更好。实际上 2 步时更好(20.7% vs 13.2%),4 步时反而更差(42.5% vs 56.8%);它生成的合法句子更”常见”(平均 7.86–8.04,低于熵 8.15),不同句子也更少——它偏向高概率的句子。在完美后验上(
03号脚本)它也没有更好(4 步 51.6% vs 58.9%)。还有一个意外:玩具语言里大量位置的置信度完全相等(1/3、1/6 这样的概率),如果不随机打破平局、由浮点舍入决定顺序,完美后验 4 步的合法率会变成约 74%(5 个种子 71.5%–75.6%)——“同样有把握时先揭开哪个”本身就是一个影响很大的设计选择。实践中置信度优先通常配合”取最可能的 token”的低温度解码,练习 7 试了这种组合。
5.3 掩码路径 vs 均匀路径
在完美后验下,均匀路径比掩码路径更好采样:8 步时 90.7% vs 67.4%,64 步时 99.4% vs 94.0%。原因是均匀路径的 token 可以被反复改写——早期的错误(例如抽了一个和别人冲突的 “sees”)在后面会被后验识别为噪声并修正(§4.2 的例子);掩码路径一旦揭开就再也不改。
但均匀路径更难学:网络必须输入 ,还要同时判断”哪些位置可信”和”该填什么”。文献里均匀噪声的离散扩散模型困惑度普遍不如掩码扩散(例如 SEDD 论文里 absorbing 优于 uniform),所以主流的扩散语言模型(MDLM、LLaDA)都用掩码路径。给掩码路径加上”重新掩码”(remasking)的采样器,是把”可以修正”的好处找回来的一种办法(延伸阅读)。
5.4 扩散语言模型 vs 自回归语言模型
| 自回归 | 掩码扩散 | |
|---|---|---|
| 生成顺序 | 固定从左到右 | 任意顺序;可以先写结尾、再填中间 |
| 每次前向生成 | 1 个 token | 可以多个(并行解码),代价是 §5.1 的误差 |
| 似然 | 精确 | 只有上界;同规模下略差(§4.4) |
| 训练任务 | 个条件分布(一种顺序) | 所有”已知 / 未知”组合的条件分布(更难) |
| 推理的计算 | KV 缓存:每步只算新 token,总计算 ≈ 一次完整前向,但要 个串行步 | 每步都是整句的完整前向(双向注意力,没有 KV 缓存);串行步数可以远少于 |
| 填空、编辑、约束 | 不自然(只能往后接) | 自然(把要改的位置换成 [MASK]) |
扩散语言模型的卖点是串行步数少:在 GPU 上,自回归解码受内存带宽限制,每步只生成一个 token,算力大量闲置;扩散模型每步对整句做一次前向,一步揭开多个 token,可以更快地生成同样长的文本。代价是总计算量更大、并行解码会出错、似然略差。LLaDA(80 亿参数,从头训练的掩码扩散模型),以及 Inception Labs 的 Mercury、Google 的 Gemini Diffusion 等商业系统,都是这条路线上的尝试。
6. 生成器匹配:一个原理统一 ODE、SDE、CTMC · Generator matching
流、扩散、跳跃,三种”运动方式”能否用一种语言描述?可以:看它们怎样改变任意一个函数的期望。定义马尔可夫过程的生成器(generator)
| 过程 | 生成器 |
|---|---|
| ODE | |
| SDE | |
| CTMC,速率 |
三种情况下,分布的演化方程都是同一句话:。对 ODE 它就是连续性方程,对 SDE 是 Fokker–Planck 方程(第 3 讲),对 CTMC 是 Kolmogorov 前向方程。
边缘化技巧也有统一的形式:如果生成器对”参数”(、、)是线性的,那么条件生成器 按后验平均就得到生成边缘路径的生成器——三讲里的三个边缘化技巧是同一个定理。这就是生成器匹配(generator matching,Holderrieth et al.):选一种过程、一条条件路径,用条件损失训练网络去匹配边缘生成器。它还允许把几种运动组合起来,比如对连续坐标用流、对离散类别用跳跃(第 9 讲的蛋白质结构–序列联合生成就是这样做的),或者在一个模型里同时用流和跳跃。
7. 小结 · Summary
- CTMC 是离散空间里的 ODE:速率矩阵 (非对角非负、每行和为 0)代替向量场;欧拉一步从 里抽,要求 ;停留时间是指数分布。
- Kolmogorov 前向方程 = “流入 − 流出”,是连续性方程的离散版; 生成 当且仅当它成立。
- 序列上用分解的速率矩阵(一次只改一个 token),网络输出 个数;Algorithm 7 对每个位置独立地做欧拉一步。
- 离散流匹配:分解混合路径 + 条件速率 + 边缘化技巧 ⇒ 边缘速率 。网络只需学后验,用交叉熵训练(Algorithm 8)。
- 掩码扩散:后验与 无关(网络不输入 );ELBO = = 随机顺序自回归的似然,后验精确时是紧的;同规模下似然略差于自回归。
- 采样:并行解码的误差来自”同一步里各位置独立”;每步揭开一个就是精确的;欧拉法 收敛;揭开的顺序(置信度优先)是一个没有普适答案的设计选择。均匀路径能自我修正、但更难学。
- 生成器匹配:ODE、SDE、CTMC 的分布演化和边缘化技巧是同一个定理。
8. 常见误区 · Common pitfalls
- “离散扩散就是对 one-hot 向量做高斯扩散。” 本讲的方法从头到尾都在离散空间里:跳跃、速率矩阵、后验。把 one-hot 嵌入连续空间再加高斯噪声是另一类方法,不在本讲范围。
- “边缘速率 = 条件速率按数据分布平均。” 要按后验 平均;按先验平均会让各位置独立地生成,TV 0.54(§3.4)。
- “掩码扩散模型需要输入时间 。” 不需要,后验和 无关(§4.2)。均匀路径才需要。
- “后验学得完美,采样就没有误差。” 同一步里多个位置独立地抽,完美后验 4 步也只有 42–59% 合法(§5.1)。
- “步数越多越好,所以欧拉法多走几步就行。” 对掩码扩散,“每步揭开几个”比”步数”更关键:固定个数 8 步胜过欧拉 64 步(§5.2)。
- “置信度优先总是更好。” 在本讲的实验里不是(§5.2),而且结果对平局的处理很敏感。
- “扩散语言模型的似然和自回归一样精确。” 只有 ELBO(上界);同规模下略差(§4.4)。
- “欧拉法的步长随便取。” 时得到负概率;线性调度下最后一步恰好 (§1.5)。
9. 练习 · Exercises
练习 1(两状态链)。推导 §1.3 的闭式解,并求 的平稳分布。对 、 验证 。
参考答案
。令 ,得 ,。平稳分布 ,此时流入 等于流出 (“细致平衡”)。、、:。
练习 2(条件速率生成混合路径)。对单个位置,验证 满足 KFE 。再说明: 个位置各自独立地按这个速率跳,合起来就是分解的速率矩阵。
参考答案
见 §3.3:右边 ,等于左边。 个独立的链在时间 内”两个位置都跳”的概率是 ,所以联合过程的速率只在恰好一个位置改变时非零,值就是那个位置的速率——这正是分解速率矩阵的定义。
练习 3(离散边缘化技巧)。补全 §3.4 的证明,并从全矩阵公式推出分解形式 。
参考答案
证明见 §3.4。对只在位置 不同的 (),,所以 。对角元由”每行和为 0”决定:,和分解形式里 的那一项一致。02 号脚本的 (c) 列数值上验证了两者相同(差 )。
练习 4(ELBO 的分层)。证明 ,从而 。
参考答案
。乘以 得 1。给定 ,被掩码集合均匀随机,;对 积分后每个 的权重恰好是 乘以 ,即 1。这个结果和 的具体形式无关(换元 即可),所以 ELBO 对调度不变——MD4 论文也指出了这一点。
练习 5(欧拉法里”同时揭开”的次数)。掩码路径、、步长 。证明同一步里同时揭开的”位置对”的期望个数(对所有步求和)是 。、 和 时各是多少?和 §5.1 的合法率对照。
参考答案
第 步(),被掩码的个数 ,每个以概率 揭开。同时揭开的对数的期望 ,与 无关; 步求和得 。: 时 3.5, 时 0.44。不是每一对同时揭开都会出错(两个不相关的位置同时揭开没关系),所以 64 步时不合法的只有 6%;但""说明误差是一阶的。
练习 6(编程:ELBO 加权)。用 train_mdlm(..., weighting="elbo") 训练(损失按 加权),和默认的”每个被掩码 token 权重相同”比较 ELBO 和 8 步采样的合法率。
参考答案(作者机器上的结果)
ELBO 加权:ELBO 8.278(比真值多 0.128),8 步合法率 95.2%;默认加权:8.242(多 0.092),96.5%。直接优化 ELBO 的那个加权,ELBO 反而更差。原因是 在 (几乎没有 [MASK])时极大( 截断在 0.999,权重最大 1000),少数样本主导梯度,方差很大。两种加权的最优解相同(都是真实后验),差别只来自有限容量和优化——和第 3 讲”四种参数化 = 四种加权”是同一个故事。实践中用 ELBO 加权时会配合降低方差的技巧(例如 VDM、MDLM 用的低差异 抽样)。
练习 7(编程:贪心解码)。把 MDLM 的后验换成 one-hot 的 argmax(“温度为 0”),分别用随机位置和置信度优先,4 步和 8 步。合法率、不同句子的个数怎样变化?
参考答案(作者机器上的结果)
| 揭开方式 | 4 步:合法 / 不同句子 | 8 步:合法 / 不同句子 |
|---|---|---|
| 随机位置 + 抽样 | 56.8% / 940 | 96.5% / 836 |
| 随机位置 + 贪心 | 57.9% / 217 | 100.0% / 121 |
| 置信度优先 + 抽样 | 42.5% / 913 | 96.8% / 827 |
| 置信度优先 + 贪心 | 100.0% / 1 | 100.0% / 1 |
贪心解码让合法率升到 100%(8 步),代价是多样性崩塌;“置信度优先 + 贪心”更彻底:从全 [MASK] 出发,每一步的位置和 token 都是确定的,1000 个样本是同一个句子。这和自回归模型的贪心解码一样:有提示(条件生成)时,确定性的输出往往是想要的(LLaDA 在问答里就这样用);无条件生成时它毫无用处。“置信度优先”在实践中好用,很大程度上是因为它和低温度解码搭配。
练习 8(思考:计算量)。句长 。自回归模型用 KV 缓存生成一整句,总计算量约等于一次完整前向;掩码扩散模型用 步,每步一次完整前向。 时总计算量是自回归的多少倍?在什么条件下扩散模型反而更快?
参考答案
约 256 倍(忽略注意力的平方项和 KV 缓存的读写)。但自回归要 1024 个串行步,每步只处理一个 token,GPU 的算力大部分闲置、瓶颈在读写权重和缓存;扩散模型只要 256 个串行步,每步处理整句,算力利用率高。当”串行步数”而不是”总算力”是瓶颈时(小批量的在线推理),扩散模型可能更快;批量很大、算力打满时,自回归的总计算优势更重要。
10. 延伸阅读 · Further reading
- 原课讲义第 7 章、附录 C,Lecture 5 slides(https://diffusion.csail.mit.edu/ )。
- Campbell et al., A Continuous Time Framework for Discrete Denoising Models(NeurIPS 2022):CTMC 视角的离散扩散。
- Campbell et al., Generative Flows on Discrete State-Spaces(Discrete Flow Models,ICML 2024);Gat et al., Discrete Flow Matching(NeurIPS 2024):本讲 §3 的框架。
- Austin et al., Structured Denoising Diffusion Models in Discrete State-Spaces(D3PM,NeurIPS 2021):离散时间版本,absorbing(掩码)与 uniform 噪声。
- Lou, Meng & Ermon, Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution(SEDD,ICML 2024):用”具体得分” 参数化速率。
- Sahoo et al., Simple and Effective Masked Diffusion Language Models(MDLM,NeurIPS 2024);Shi et al., Simplified and Generalized Masked Diffusion for Discrete Data(MD4,NeurIPS 2024);Ou et al., Your Absorbing Discrete Diffusion Secretly Models the Conditional Distributions of Clean Data(RADD,ICLR 2025):§4 的 ELBO 与”后验与 无关”。
- Nie et al., Large Language Diffusion Models(LLaDA,2025):80 亿参数的掩码扩散语言模型,置信度优先的重新掩码。
- Chang et al., MaskGIT(CVPR 2022):图像 token 上的置信度优先并行解码。
- Wang et al., Remasking Discrete Diffusion Models with Inference-Time Scaling(ReMDM,2025):给掩码扩散加上”可以修正”的采样器。
- Holderrieth et al., Generator Matching: Generative Modeling with Arbitrary Markov Processes(ICLR 2025):§6。
11. 下一讲预告 · Next lecture
到这里,原课 2026 年的五讲内容都讲完了。接下来三讲是扩展讲。第 7 讲回到连续空间,处理一个本讲也遇到过的问题:步数。流模型通常要模拟几十步 ODE,掩码扩散要几十步才能少犯并行解码的错。能不能一两步就生成?
- 为什么步数少就会出错?——轨迹是弯的,欧拉法一步只能走直线(第 1 讲里”一步塌缩到数据均值”就是极端情况)。
- Rectified Flow / reflow:把轨迹”拉直”。
- 蒸馏与一致性模型:让学生一步跳到老师多步走到的地方。
- MeanFlow:不学瞬时速度,学”平均速度”,一步生成。