对应 Maps to :MIT 6.S184 原课讲义(Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models , 2026 版)附录 A (概率回顾:随机向量、条件密度与条件期望),以及正课里隐含使用的向量微积分(散度、拉普拉斯算子、变量替换、分部积分)。
依据说明 :原课的先修要求是”线性代数、多元微积分和基础概率论”,讲义只用两页附录 A 回顾概率。本讲按”正课里真正会用到 什么”重新组织:§1–§4 对应附录 A 并扩充;§5–§6 的向量微积分是本讲义补充的,它们在第 2 讲(连续性方程)、第 3 讲(Fokker–Planck 方程、得分匹配)里会用到。所有例子和实验都是本讲义设计的。
配套代码 Code :code/prereq1/建议阅读时间 :第 1 讲之前或同时读;第 2 讲之前必须读完 (尤其 §4 条件期望)。预计 3 小时(含运行代码)。
0. 本讲导航 · How to read this lecture
0.1 为什么需要这一讲
流匹配和扩散模型的推导,翻来覆去只用到少数几样数学工具。问题是,它们往往以一种初学者不熟悉的方式出现:
第 2 讲的”边缘向量场”是一个条件期望 E [ u t ( x ∣ z ) ∣ x ] \mathbb{E}[\,u_t(x \mid z) \mid x\,] E [ u t ( x ∣ z ) ∣ x ]
第 2 讲的核心定理”条件流匹配损失 = 流匹配损失 + 常数”,本质上是均方误差的一个分解 ;
第 2 讲的”连续性方程”∂ t p t = − div ( p t u t ) \partial_t p_t = -\operatorname{div}(p_t u_t) ∂ t p t = − div ( p t u t ) 散度 是什么意思;
第 3 讲的 Fokker–Planck 方程多了一个拉普拉斯算子 ;
第 3 讲的得分函数是对数密度的梯度 ,而高斯的得分是一个简单的线性函数。
这一讲把这些工具逐个讲清楚,并且每个工具都配一个数值实验 :你可以亲眼看到”回归学到的是条件期望""散度等于单位面积的净流出”这些说法在数字上成立。
0.2 学习目标 Learning goals
学完这一讲,你应该能够:
把期望理解成”使平均平方距离最小的常数”,会用蒙特卡洛估计期望,知道误差按 1 / N 1/\sqrt{N} 1/ N
熟练使用高斯分布:重参数化、线性变换、独立高斯相加、方差趋于 0 的极限(狄拉克 δ)、得分函数;知道高维高斯的样本集中在半径 d \sqrt{d} d
区分联合、边缘、条件分布,会用贝叶斯公式算后验;理解为什么”从边缘分布采样”容易而”算边缘密度”困难。
区分 E [ X ∣ Y = y ] \mathbb{E}[X \mid Y = y] E [ X ∣ Y = y ] E [ X ∣ Y ] \mathbb{E}[X \mid Y] E [ X ∣ Y ] 用均方误差做回归,学到的是条件期望 ;能写出并证明均方误差的分解式。
理解梯度、雅可比矩阵、散度、拉普拉斯算子的几何意义,会用自动求导计算它们;会用乘积法则和分部积分。
写出变量替换公式,理解流的”瞬时变量替换” d d t log p t ( X t ) = − div u t ( X t ) \frac{d}{dt}\log p_t(X_t) = -\operatorname{div}u_t(X_t) d t d log p t ( X t ) = − div u t ( X t )
0.3 本讲地图 Map
§1  随机向量、期望与蒙特卡洛                    ← 代码 01
§2  高斯分布:重参数化、相加、δ、得分、肥皂泡    ← 代码 02
§3  联合、边缘、条件与贝叶斯                    ← 代码 03
§4  条件期望:回归学到的是什么(最重要)        ← 代码 04
§5  向量微积分:梯度、散度、拉普拉斯、分部积分  ← 代码 05
§6  变量替换与流的瞬时变量替换                  ← 代码 06
§7  工具 → 正课里在哪用
§8  小结   §9  常见误区   §10 练习   §11 延伸阅读   §12 下一篇预告
0.4 记号 Notation
记号 意思 X , Y , Z X, Y, Z X , Y , Z 随机变量 / 随机向量(大写) x , y , z x, y, z x , y , z 它们的取值(小写) p X ( x ) p_X(x) p X ( x ) p ( x ) p(x) p ( x ) X X X X ∼ p X \sim p X ∼ p X X X p p p N ( μ , σ 2 I d ) \mathcal{N}(\mu, \sigma^2 I_d) N ( μ , σ 2 I d ) 均值 μ \mu μ σ 2 \sigma^2 σ 2 d d d ⟨ x , y ⟩ = ∑ i x i y i \langle x, y\rangle = \sum_i x_i y_i ⟨ x , y ⟩ = ∑ i x i y i ∥ x ∥ = ⟨ x , x ⟩ \lVert x\rVert = \sqrt{\langle x, x\rangle} ∥ x ∥ = ⟨ x , x ⟩ 内积与欧氏范数 ∇ f \nabla f ∇ f J u J_u J u div u \operatorname{div} u div u Δ f \Delta f Δ f 梯度、雅可比矩阵、散度、拉普拉斯算子(§5)
1. 随机向量、期望与蒙特卡洛 · Random vectors & Monte Carlo
1.1 随机向量与密度
这门课里,数据是 R d \mathbb{R}^d R d 随机向量 X = ( X 1 , … , X d ) ∈ R d X = (X_1, \dots, X_d) \in \mathbb{R}^d X = ( X 1 , … , X d ) ∈ R d 概率密度函数 (PDF)p X : R d → R ≥ 0 p_X: \mathbb{R}^d \to \mathbb{R}_{\ge 0} p X : R d → R ≥ 0
P ( X ∈ A ) = ∫ A p X ( x ) d x , ∫ p X ( x ) d x = 1. P(X \in A) = \int_A p_X(x)\,dx,\qquad \int p_X(x)\,dx = 1. P ( X ∈ A ) = ∫ A p X ( x ) d x , ∫ p X ( x ) d x = 1. 密度本身不是概率:p X ( x ) p_X(x) p X ( x ) p X ( x ) ⋅ ( 一小块面积 ) ≈ p_X(x)\cdot(\text{一小块面积})\approx p X ( x ) ⋅ ( 一小块面积 ) ≈
1.2 期望:最小二乘意义下最接近 X X X
期望通常定义为加权平均 E [ X ] = ∫ x p X ( x ) d x \mathbb{E}[X] = \int x\,p_X(x)\,dx E [ X ] = ∫ x p X ( x ) d x
E [ X ] = arg min z ∈ R d ∫ ∥ x − z ∥ 2 p X ( x ) d x = arg min z E ∥ X − z ∥ 2 . \mathbb{E}[X] = \arg\min_{z \in \mathbb{R}^d} \int \lVert x - z\rVert^2 p_X(x)\,dx = \arg\min_z \mathbb{E}\lVert X - z\rVert^2. E [ X ] = arg z ∈ R d min ∫ ∥ x − z ∥ 2 p X ( x ) d x = arg z min E ∥ X − z ∥ 2 . 期望是”离 X X X 证明只需展开:
E ∥ X − z ∥ 2 = E ∥ X − E X ∥ 2 + ∥ E X − z ∥ 2 , \mathbb{E}\lVert X - z\rVert^2 = \mathbb{E}\lVert X - \mathbb{E}X\rVert^2 + \lVert \mathbb{E}X - z\rVert^2, E ∥ X − z ∥ 2 = E ∥ X − E X ∥ 2 + ∥ E X − z ∥ 2 , (交叉项 2 ⟨ E [ X − E X ] , E X − z ⟩ = 0 2\langle \mathbb{E}[X - \mathbb{E}X],\ \mathbb{E}X - z\rangle = 0 2 ⟨ E [ X − E X ] , E X − z ⟩ = 0 z z z z = E X z = \mathbb{E}X z = E X
01 号脚本第 1 部分在一个偏斜的指数分布(均值 2、方差 4、中位数 2 ln 2 ≈ 1.386 2\ln 2 \approx 1.386 2 ln 2 ≈ 1.386
z z z 0 1 1.386(中位数) 2(均值) 3 4 E ( X − z ) 2 \mathbb{E}(X - z)^2 E ( X − z ) 2 7.909 4.926 4.309 3.943 4.960 7.977
最小值出现在均值处,最小值等于方差(不是 0);网格搜索的最优点 1.995 与样本均值 1.995 相同。如果把平方距离换成绝对距离 E ∣ X − z ∣ \mathbb{E}\lvert X - z\rvert E ∣ X − z ∣ 用什么损失,决定了学到的是什么统计量 :这门课所有训练目标都是均方误差,所以学到的都是某种(条件)均值。§4 会把这一点推到”条件”的情形,那是本讲最重要的结论。
1.3 无意识统计学家定律(LOTUS)
要算 E [ f ( X ) ] \mathbb{E}[f(X)] E [ f ( X )] f ( X ) f(X) f ( X ) X X X
E [ f ( X ) ] = ∫ f ( x ) p X ( x ) d x . \mathbb{E}[f(X)] = \int f(x)\,p_X(x)\,dx. E [ f ( X )] = ∫ f ( x ) p X ( x ) d x . 这个名字(law of the unconscious statistician)来自一个玩笑:它太自然了,人们”无意识”地就这么用了。01 号脚本第 2 部分在 X ∼ N ( 1 , 0.5 2 ) X \sim \mathcal{N}(1, 0.5^2) X ∼ N ( 1 , 0. 5 2 ) f = x , x 2 , sin x , e x f = x, x^2, \sin x, e^x f = x , x 2 , sin x , e x E [ e X ] = e 1.125 = 3.0802 \mathbb{E}[e^X] = e^{1.125} = 3.0802 E [ e X ] = e 1.125 = 3.0802 e X e^X e X
1.4 蒙特卡洛估计:只要会采样,就能估计期望
如果只有 X X X x 1 , … , x N x_1, \dots, x_N x 1 , … , x N
E [ f ( X ) ] ≈ 1 N ∑ i = 1 N f ( x i ) . \mathbb{E}[f(X)] \approx \frac{1}{N}\sum_{i=1}^N f(x_i). E [ f ( X )] ≈ N 1 i = 1 ∑ N f ( x i ) . 这叫蒙特卡洛估计 。它是无偏的,误差的标准差是
Var [ f ( X ) ] / N . \sqrt{\operatorname{Var}[f(X)] / N}. Var [ f ( X )] / N . 01 号脚本第 3 部分用 N N N E [ X 2 ] = 1 \mathbb{E}[X^2] = 1 E [ X 2 ] = 1 N N N
N N N 10 100 1,000 10,000 100,000 估计的标准差 0.425 0.142 0.042 0.0139 0.0042 理论 2 / N \sqrt{2/N} 2/ N 0.447 0.141 0.045 0.0141 0.0045
样本数翻 100 倍,误差只缩小 10 倍。训练神经网络时,每个小批量上的损失就是这样一个带噪声的蒙特卡洛估计;批量越大,梯度的噪声越小。
1.5 维数灾难:为什么一切都要建立在”采样”上
在 d d d 10 d 10^d 1 0 d d = 12288 d = 12288 d = 12288 10 12288 10^{12288} 1 0 12288 10 80 10^{80} 1 0 80 Var f / N \sqrt{\operatorname{Var}f/N} Var f / N Var f \operatorname{Var} f Var f 01 号脚本第 4 部分用 1000 个样本估计 E ∥ X ∥ 2 / d \mathbb{E}\lVert X\rVert^2/d E ∥ X ∥ 2 / d
维数 d d d 1 10 100 1000 12288 10 次估计的标准差 0.035 0.011 0.0028 0.0013 0.0002
误差甚至随 d d d ∥ X ∥ 2 / d \lVert X\rVert^2/d ∥ X ∥ 2 / d 训练时只需要会采样,从不需要在空间里做积分 。
📌 代码 01 :python3 01_expectation_and_monte_carlo.py。
2. 高斯分布 · The Gaussian
2.1 密度与重参数化
d d d
N ( x ; μ , σ 2 I d ) = ( 2 π σ 2 ) − d / 2 exp ( − ∥ x − μ ∥ 2 2 σ 2 ) , log N ( x ; μ , σ 2 I d ) = − ∥ x − μ ∥ 2 2 σ 2 − d 2 log ( 2 π σ 2 ) . \mathcal{N}(x; \mu, \sigma^2 I_d) = (2\pi\sigma^2)^{-d/2}\exp\Big(-\frac{\lVert x - \mu\rVert^2}{2\sigma^2}\Big),\qquad
\log\mathcal{N}(x; \mu, \sigma^2 I_d) = -\frac{\lVert x - \mu\rVert^2}{2\sigma^2} - \frac{d}{2}\log(2\pi\sigma^2). N ( x ; μ , σ 2 I d ) = ( 2 π σ 2 ) − d /2 exp ( − 2 σ 2 ∥ x − μ ∥ 2 ) , log N ( x ; μ , σ 2 I d ) = − 2 σ 2 ∥ x − μ ∥ 2 − 2 d log ( 2 π σ 2 ) . 从它采样的标准方法是重参数化 :
ϵ ∼ N ( 0 , I d ) ⟹ x = μ + σ ϵ ∼ N ( μ , σ 2 I d ) . \epsilon \sim \mathcal{N}(0, I_d)\ \Longrightarrow\ x = \mu + \sigma\epsilon \sim \mathcal{N}(\mu, \sigma^2 I_d). ϵ ∼ N ( 0 , I d ) ⟹ x = μ + σ ϵ ∼ N ( μ , σ 2 I d ) . 即”从标准高斯采样 + 一个确定的变换”。这门课里它无处不在:第 2 讲的 x t = α t z + β t ϵ x_t = \alpha_t z + \beta_t\epsilon x t = α t z + β t ϵ z = μ ϕ ( x ) + σ ϕ ( x ) ϵ z = \mu_\phi(x) + \sigma_\phi(x)\epsilon z = μ ϕ ( x ) + σ ϕ ( x ) ϵ 02 号脚本第 1 部分核对了手写公式与 torch.distributions 的对数密度(最大差 8.9 × 10 − 16 8.9\times10^{-16} 8.9 × 1 0 − 16
2.2 线性变换与 Cholesky 采样
若 X ∼ N ( μ , Σ ) X \sim \mathcal{N}(\mu, \Sigma) X ∼ N ( μ , Σ ) Y = A X + b ∼ N ( A μ + b , A Σ A ⊤ ) Y = AX + b \sim \mathcal{N}(A\mu + b,\ A\Sigma A^\top) Y = A X + b ∼ N ( A μ + b , A Σ A ⊤ ) 高斯经过线性变换仍是高斯 。反过来,任何协方差矩阵 Σ \Sigma Σ Σ = L L ⊤ \Sigma = LL^\top Σ = L L ⊤ L L L Z = L ϵ ∼ N ( 0 , Σ ) Z = L\epsilon \sim \mathcal{N}(0, \Sigma) Z = L ϵ ∼ N ( 0 , Σ ) 02 号脚本第 2 部分:A = ( 2 0 1.5 0.5 ) A = \begin{pmatrix}2 & 0\\ 1.5 & 0.5\end{pmatrix} A = ( 2 1.5 0 0.5 ) Y Y Y ( 3.98 2.98 2.98 2.48 ) \begin{pmatrix}3.98 & 2.98\\ 2.98 & 2.48\end{pmatrix} ( 3.98 2.98 2.98 2.48 ) A A ⊤ = ( 4 3 3 2.5 ) AA^\top = \begin{pmatrix}4 & 3\\ 3 & 2.5\end{pmatrix} A A ⊤ = ( 4 3 3 2.5 )
这门课里的高斯几乎都是各向同性的 σ 2 I \sigma^2 I σ 2 I
2.3 独立高斯相加:高斯概率路径的核心计算
若 z ∼ N ( m , s 2 ) z \sim \mathcal{N}(m, s^2) z ∼ N ( m , s 2 ) ϵ ∼ N ( 0 , 1 ) \epsilon \sim \mathcal{N}(0, 1) ϵ ∼ N ( 0 , 1 )
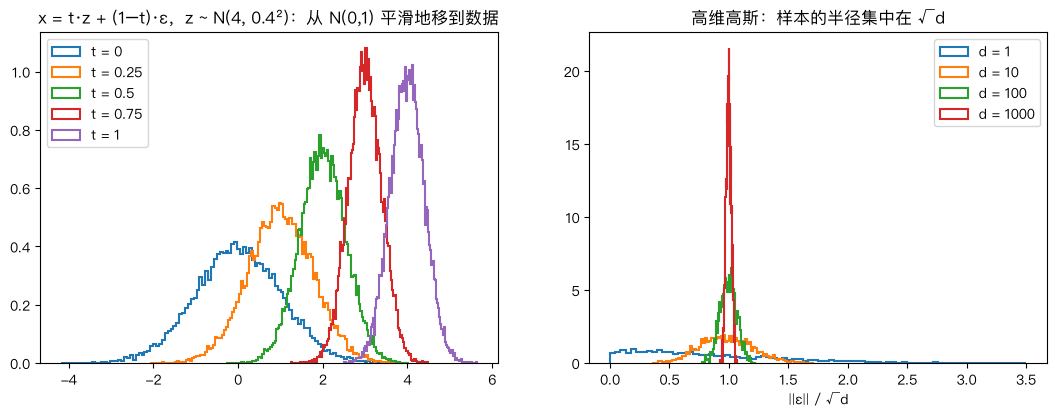
x = α z + β ϵ ∼ N ( α m , α 2 s 2 + β 2 ) . x = \alpha z + \beta\epsilon \sim \mathcal{N}\big(\alpha m,\ \alpha^2 s^2 + \beta^2\big). x = α z + β ϵ ∼ N ( α m , α 2 s 2 + β 2 ) . 均值相加,方差相加(系数要平方)。 02 号脚本第 3 部分取 m = 4 m = 4 m = 4 s = 0.4 s = 0.4 s = 0.4 α = t \alpha = t α = t β = 1 − t \beta = 1 - t β = 1 − t
t t t 0 0.25 0.5 0.75 1 样本均值 / 公式 α m \alpha m α m −0.0005 / 0 0.9996 / 1 1.9997 / 2 2.9997 / 3 3.9998 / 4 样本方差 / 公式 α 2 s 2 + β 2 \alpha^2 s^2 + \beta^2 α 2 s 2 + β 2 1.007 / 1 0.577 / 0.573 0.292 / 0.290 0.154 / 0.153 0.160 / 0.160
t t t N ( 0 , 1 ) \mathcal{N}(0, 1) N ( 0 , 1 ) N ( 4 , 0.4 2 ) \mathcal{N}(4, 0.4^2) N ( 4 , 0. 4 2 ) p t p_t p t
2.4 方差趋于 0:狄拉克 δ
N ( z , β 2 ) \mathcal{N}(z, \beta^2) N ( z , β 2 ) β → 0 \beta \to 0 β → 0 02 号脚本第 4 部分(z = 1.3 z = 1.3 z = 1.3
β \beta β 1 0.1 0.01 0.001 0 z z z 0.4 4.0 39.9 398.9 ∞ P ( ∣ X − z ∣ > 0.01 ) P(\lvert X - z\rvert > 0.01) P (∣ X − z ∣ > 0.01 ) 0.992 0.921 0.315 0.000 0.000
峰越来越高(总面积始终是 1),概率越来越集中。β = 0 \beta = 0 β = 0 X ≡ z X \equiv z X ≡ z z z z 狄拉克 δ 分布 δ z \delta_z δ z z z z E [ f ( X ) ] = f ( z ) \mathbb{E}[f(X)] = f(z) E [ f ( X )] = f ( z ) p t ( ⋅ ∣ z ) = N ( α t z , β t 2 I ) p_t(\cdot \mid z) = \mathcal{N}(\alpha_t z, \beta_t^2 I) p t ( ⋅ ∣ z ) = N ( α t z , β t 2 I ) β 1 = 0 \beta_1 = 0 β 1 = 0 t = 1 t = 1 t = 1 δ z \delta_z δ z
2.5 得分函数:对数密度的梯度
对上面的对数密度求梯度:
∇ x log N ( x ; μ , σ 2 I ) = − x − μ σ 2 . \nabla_x \log\mathcal{N}(x; \mu, \sigma^2 I) = -\frac{x - \mu}{\sigma^2}. ∇ x log N ( x ; μ , σ 2 I ) = − σ 2 x − μ . 这叫高斯的得分函数 (score)。它是一支指向均值 的箭头,长度 = 距离 / σ 2 /\ \sigma^2 / σ 2 02 号脚本第 5 部分用自动求导核对了这个公式(μ = ( 1 , 1 ) \mu = (1, 1) μ = ( 1 , 1 ) σ = 0.5 \sigma = 0.5 σ = 0.5 ( 1 , 3 ) (1, 3) ( 1 , 3 ) ( 0 , − 8 ) (0, -8) ( 0 , − 8 ) ( − 1 , − 1 ) (-1, -1) ( − 1 , − 1 ) ( 8 , 8 ) (8, 8) ( 8 , 8 )
注意,对数密度里的归一化常数 − d 2 log ( 2 π σ 2 ) -\frac{d}{2}\log(2\pi\sigma^2) − 2 d log ( 2 π σ 2 ) x x x 算得分函数不需要知道归一化常数 。对于一般的分布 p ( x ) = p ~ ( x ) / C p(x) = \tilde p(x)/C p ( x ) = p ~ ( x ) / C C = ∫ p ~ C = \int\tilde p C = ∫ p ~ ∇ log p = ∇ log p ~ \nabla\log p = \nabla\log\tilde p ∇ log p = ∇ log p ~
2.6 高维高斯的”肥皂泡”
标准高斯的密度在原点最高。那么高维时,样本是不是大多在原点附近?02 号脚本第 6 部分:
维数 d d d 1 2 10 100 1000 12288 d \sqrt{d} d 1.00 1.41 3.16 10.00 31.62 110.85 ∥ ϵ ∥ \lVert\epsilon\rVert ∥ ϵ ∥ 0.79 1.26 3.09 9.98 31.61 110.83 ∥ ϵ ∥ \lVert\epsilon\rVert ∥ ϵ ∥ 0.60 0.66 0.70 0.70 0.71 0.72 ∥ ϵ ∥ < 0.5 d \lVert\epsilon\rVert < 0.5\sqrt{d} ∥ ϵ ∥ < 0.5 d 0.39 0.22 0.010 0 0 0
d d d 没有任何样本 靠近原点:∥ ϵ ∥ \lVert\epsilon\rVert ∥ ϵ ∥ d \sqrt{d} d d d d [ r , r + d r ] [r, r + dr] [ r , r + d r ] r d − 1 r^{d-1} r d − 1 r ≈ d r \approx \sqrt{d} r ≈ d
这和第 1 讲 §1.4 “最可能的点 ≠ 典型的点”是同一件事。对图像来说:一张纯噪声图(d ≈ 1.2 d \approx 1.2 d ≈ 1.2
📌 代码 02 :python3 02_gaussians.py。
3. 联合、边缘、条件与贝叶斯 · Joint, marginal, conditional
3.1 定义
两个随机向量 X , Y X, Y X , Y 联合密度 p X , Y ( x , y ) p_{X,Y}(x, y) p X , Y ( x , y )
边缘密度 (对另一个变量积分):p X ( x ) = ∫ p X , Y ( x , y ) d y p_X(x) = \int p_{X,Y}(x, y)\,dy p X ( x ) = ∫ p X , Y ( x , y ) d y p Y ( y ) = ∫ p X , Y ( x , y ) d x p_Y(y) = \int p_{X,Y}(x, y)\,dx p Y ( y ) = ∫ p X , Y ( x , y ) d x 条件密度 (固定一个变量、重新归一化):p X ∣ Y ( x ∣ y ) = p X , Y ( x , y ) p Y ( y ) p_{X \mid Y}(x \mid y) = \dfrac{p_{X,Y}(x, y)}{p_Y(y)} p X ∣ Y ( x ∣ y ) = p Y ( y ) p X , Y ( x , y ) p Y ( y ) > 0 p_Y(y) > 0 p Y ( y ) > 0 贝叶斯公式 (把条件反过来):p Y ∣ X ( y ∣ x ) = p X ∣ Y ( x ∣ y ) p Y ( y ) p X ( x ) p_{Y \mid X}(y \mid x) = \dfrac{p_{X \mid Y}(x \mid y)\,p_Y(y)}{p_X(x)} p Y ∣ X ( y ∣ x ) = p X ( x ) p X ∣ Y ( x ∣ y ) p Y ( y )
在生成模型的语境里,p Y p_Y p Y 先验 ,p X ∣ Y p_{X\mid Y} p X ∣ Y 似然 ,p Y ∣ X p_{Y \mid X} p Y ∣ X 后验 。
3.2 高斯混合:一个两步的联合分布
高斯混合 p ( x ) = ∑ k w k N ( x ; m k , s k 2 ) p(x) = \sum_k w_k\,\mathcal{N}(x; m_k, s_k^2) p ( x ) = ∑ k w k N ( x ; m k , s k 2 ) k ∼ p ( k ) = w k k \sim p(k) = w_k k ∼ p ( k ) = w k x ∼ p ( x ∣ k ) = N ( m k , s k 2 ) x \sim p(x \mid k) = \mathcal{N}(m_k, s_k^2) x ∼ p ( x ∣ k ) = N ( m k , s k 2 ) k k k p ( x ) p(x) p ( x ) x x x
p ( k ∣ x ) = w k N ( x ; m k , s k 2 ) ∑ j w j N ( x ; m j , s j 2 ) . p(k \mid x) = \frac{w_k\,\mathcal{N}(x; m_k, s_k^2)}{\sum_j w_j\,\mathcal{N}(x; m_j, s_j^2)}. p ( k ∣ x ) = ∑ j w j N ( x ; m j , s j 2 ) w k N ( x ; m k , s k 2 ) . 03 号脚本第 1 部分(权重 0.5/0.3/0.2,中心 −2/0/2.5,标准差 0.7)抽了 40 万个 ( k , x ) (k, x) ( k , x ) x 0 x_0 x 0
x 0 x_0 x 0 −2 −1 0 1 1.5 2.5 样本频率 0.989/0.011/0.000 0.626/0.374/0.000 0.025/0.974/0.001 0.001/0.842/0.157 0.000/0.295/0.705 0.000/0.003/0.997 贝叶斯公式 0.990/0.010/0.000 0.625/0.375/0.000 0.027/0.972/0.001 0.000/0.843/0.157 0.000/0.295/0.705 0.000/0.003/0.997
离某个中心近时后验几乎确定,两个成分之间则”两边都有可能”。第 1 讲里高斯混合的得分函数和理想向量场,都是按这个后验对各成分加权平均。
3.3 连续隐变量:高斯的后验
再看一个连续的例子:Z ∼ N ( 0 , 1 ) Z \sim \mathcal{N}(0, 1) Z ∼ N ( 0 , 1 ) X = Z + σ ϵ X = Z + \sigma\epsilon X = Z + σ ϵ ( Z , X ) (Z, X) ( Z , X )
p ( z ∣ x ) = N ( x 1 + σ 2 , σ 2 1 + σ 2 ) . p(z \mid x) = \mathcal{N}\Big(\frac{x}{1 + \sigma^2},\ \frac{\sigma^2}{1 + \sigma^2}\Big). p ( z ∣ x ) = N ( 1 + σ 2 x , 1 + σ 2 σ 2 ) . 03 号脚本第 2 部分用 100 万个样本验证(例如 σ = 3 \sigma = 3 σ = 3 x = 1 x = 1 x = 1 Z Z Z ≈ x \approx x ≈ x x x x z z z 去噪 ,第 2、3 讲的核心对象。
3.4 边缘分布:采样容易,算密度难
p ( x ) = ∫ p ( x ∣ z ) p data ( z ) d z p(x) = \int p(x \mid z)\,p_{\text{data}}(z)\,dz p ( x ) = ∫ p ( x ∣ z ) p data ( z ) d z
采样很容易 :先抽一个 z ∼ p data z \sim p_{\text{data}} z ∼ p data x ∼ p ( x ∣ z ) x \sim p(x \mid z) x ∼ p ( x ∣ z ) 祖先采样 (ancestral sampling)。算密度很难 :要对所有 z z z p data p_{\text{data}} p data N N N ∝ N \propto N ∝ N p data p_{\text{data}} p data
03 号脚本第 3 部分对 1000 个点计时:数据集从 100 个点增加到 100 万个点,采样的时间始终在毫秒以下,算密度的时间从几毫秒增加到 3–4 秒(具体数字随机器而变)。第 2 讲的流匹配之所以可行,正因为它只需要从边缘分布采样,从不需要算它的密度 。
📌 代码 03 :python3 03_joint_marginal_conditional.py。
4. 条件期望:回归学到的是什么 · Conditional expectation
这是本讲最重要的一节。第 2 讲的核心定理,几乎就是本节结论的直接应用。
4.1 两个不同的对象
条件期望函数 :对每个 y y y p Y ( y ) > 0 p_Y(y) > 0 p Y ( y ) > 0
E [ X ∣ Y = y ] = ∫ x p X ∣ Y ( x ∣ y ) d x . \mathbb{E}[X \mid Y = y] = \int x\,p_{X \mid Y}(x \mid y)\,dx. E [ X ∣ Y = y ] = ∫ x p X ∣ Y ( x ∣ y ) d x . 它是一个函数 R d → R d \mathbb{R}^d \to \mathbb{R}^d R d → R d y y y Y = y Y = y Y = y X X X g ⋆ ( y ) g_\star(y) g ⋆ ( y ) Y Y Y
E [ X ∣ Y ] = g ⋆ ( Y ) , \mathbb{E}[X \mid Y] = g_\star(Y), E [ X ∣ Y ] = g ⋆ ( Y ) , 它是一个随机变量 。原课讲义特意提醒:这两个东西都常被叫做”条件期望”,但它们是不同的对象。前者是函数,后者是随机变量。
4.2 回归学到的是条件期望
§1.2 说期望是”最接近 X X X 在所有以 Y Y Y E [ X ∣ Y = ⋅ ] \mathbb{E}[X \mid Y = \cdot\,] E [ X ∣ Y = ⋅ ] X X X :
g ⋆ = arg min g : R d → R d E ∥ X − g ( Y ) ∥ 2 . g_\star = \arg\min_{g:\,\mathbb{R}^d \to \mathbb{R}^d}\ \mathbb{E}\lVert X - g(Y)\rVert^2. g ⋆ = arg g : R d → R d min E ∥ X − g ( Y ) ∥ 2 . 证明:把期望写成 ∫ ( ∫ ∥ x − g ( y ) ∥ 2 p ( x ∣ y ) d x ) p ( y ) d y \int\big(\int\lVert x - g(y)\rVert^2 p(x \mid y)\,dx\big)p(y)\,dy ∫ ( ∫ ∥ x − g ( y ) ∥ 2 p ( x ∣ y ) d x ) p ( y ) d y y y y g ( y ) g(y) g ( y ) g ( y ) = E [ X ∣ Y = y ] g(y) = \mathbb{E}[X \mid Y = y] g ( y ) = E [ X ∣ Y = y ] y y y
这正是监督学习里的回归 :训练样本是 ( y i , x i ) (y_i, x_i) ( y i , x i ) g g g x i x_i x i
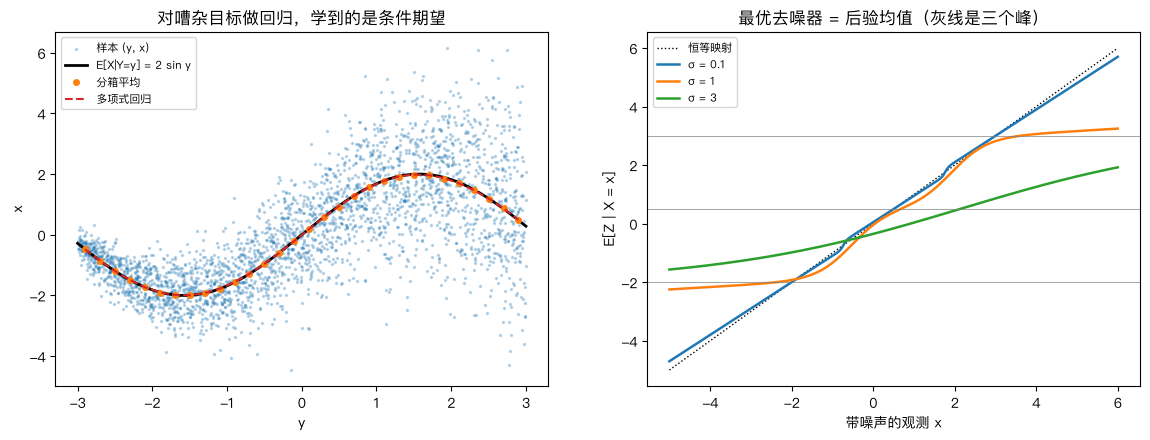
04 号脚本第 1–2 部分的例子:Y ∼ U n i f ( − 3 , 3 ) Y \sim \mathrm{Unif}(-3, 3) Y ∼ Unif ( − 3 , 3 ) X = 2 sin Y + X = 2\sin Y + X = 2 sin Y + 2 sin y 2\sin y 2 sin y 1.0 × 10 − 4 1.0\times10^{-4} 1.0 × 1 0 − 4
y y y −2.5 −1.5 −0.5 +0.5 +1.5 +2.5 真值 2 sin y 2\sin y 2 sin y −1.197 −1.995 −0.959 +0.959 +1.995 +1.197 多项式回归 −1.196 −1.995 −0.960 +0.951 +1.984 +1.196
损失降不到 0 :回归的均方误差是 1.286,而不可约的部分 E [ Var ( X ∣ Y ) ] \mathbb{E}[\operatorname{Var}(X \mid Y)] E [ Var ( X ∣ Y )] g g g y y y
4.3 均方误差的分解
对任意 函数 g g g
E ∥ X − g ( Y ) ∥ 2 = E ∥ X − E [ X ∣ Y ] ∥ 2 ⏟ 与 g 无关的常数 + E ∥ E [ X ∣ Y ] − g ( Y ) ∥ 2 \boxed{\ \mathbb{E}\lVert X - g(Y)\rVert^2 = \underbrace{\mathbb{E}\lVert X - \mathbb{E}[X \mid Y]\rVert^2}_{\text{与 } g \text{ 无关的常数}} + \mathbb{E}\lVert \mathbb{E}[X \mid Y] - g(Y)\rVert^2\ } E ∥ X − g ( Y ) ∥ 2 = 与 g 无关的常数 E ∥ X − E [ X ∣ Y ] ∥ 2 + E ∥ E [ X ∣ Y ] − g ( Y ) ∥ 2 证明:在 X − g ( Y ) = ( X − E [ X ∣ Y ] ) + ( E [ X ∣ Y ] − g ( Y ) ) X - g(Y) = \big(X - \mathbb{E}[X\mid Y]\big) + \big(\mathbb{E}[X\mid Y] - g(Y)\big) X − g ( Y ) = ( X − E [ X ∣ Y ] ) + ( E [ X ∣ Y ] − g ( Y ) )
2 E ⟨ X − E [ X ∣ Y ] , E [ X ∣ Y ] − g ( Y ) ⟩ . 2\,\mathbb{E}\big\langle X - \mathbb{E}[X \mid Y],\ \mathbb{E}[X \mid Y] - g(Y)\big\rangle. 2 E ⟨ X − E [ X ∣ Y ] , E [ X ∣ Y ] − g ( Y ) ⟩ . 先对固定的 Y Y Y Y Y Y E [ X ∣ Y ] − E [ X ∣ Y ] = 0 \mathbb{E}[X \mid Y] - \mathbb{E}[X \mid Y] = 0 E [ X ∣ Y ] − E [ X ∣ Y ] = 0
04 号脚本第 3 部分用 100 万个样本对五个候选函数验证:
候选 g g g E ( X − g ) 2 \mathbb{E}(X - g)^2 E ( X − g ) 2 常数项 E ( E [ X ∣ Y ] − g ) 2 \mathbb{E}(\mathbb{E}[X\mid Y] - g)^2 E ( E [ X ∣ Y ] − g ) 2 两项之和 2 sin y 2\sin y 2 sin y 1.2884 1.2884 0.0000 1.2884 0 0 0 3.3808 1.2884 2.0943 3.3827 y y y 2.2329 1.2884 0.9440 2.2324 2 sin y + 0.5 2\sin y + 0.5 2 sin y + 0.5 1.5406 1.2884 0.2500 1.5384 1.5 sin y 1.5\sin y 1.5 sin y 1.4188 1.2884 0.1309 1.4193
(约 0.002 的出入是抽样误差。)这个分解的含义非常深远 :
“让 g g g X X X g g g E [ X ∣ Y ] \mathbb{E}[X \mid Y] E [ X ∣ Y ] g g g g g g 梯度也完全相同 。
第 2 讲里,X X X 条件向量场 u t ( x ∣ z ) u_t(x \mid z) u t ( x ∣ z ) E [ X ∣ Y ] \mathbb{E}[X \mid Y] E [ X ∣ Y ] 边缘向量场 u t ( x ) u_t(x) u t ( x )
4.4 塔式法则
E [ E [ X ∣ Y ] ] = E [ X ] . \mathbb{E}\big[\mathbb{E}[X \mid Y]\big] = \mathbb{E}[X]. E [ E [ X ∣ Y ] ] = E [ X ] . 先在每个 y y y y y y X X X ∫ ( ∫ x p ( x ∣ y ) d x ) p ( y ) d y = ∬ x p ( x , y ) d x d y = ∫ x p ( x ) d x \int\big(\int x\,p(x \mid y)\,dx\big)p(y)\,dy = \iint x\,p(x, y)\,dx\,dy = \int x\,p(x)\,dx ∫ ( ∫ x p ( x ∣ y ) d x ) p ( y ) d y = ∬ x p ( x , y ) d x d y = ∫ x p ( x ) d x 04 号脚本第 4 部分:E [ X ] \mathbb{E}[X] E [ X ] E [ 2 sin Y ] \mathbb{E}[2\sin Y] E [ 2 sin Y ]
还有一个常用的性质:E [ f ( X , Y ) ∣ Y = y ] = ∫ f ( x , y ) p ( x ∣ y ) d x \mathbb{E}[f(X, Y) \mid Y = y] = \int f(x, y)\,p(x \mid y)\,dx E [ f ( X , Y ) ∣ Y = y ] = ∫ f ( x , y ) p ( x ∣ y ) d x z z z z z z
4.5 最优去噪器 = 后验均值
把 §3.3 和 §4.2 合起来:如果 X = Z + σ ϵ X = Z + \sigma\epsilon X = Z + σ ϵ g ( x ) ≈ Z g(x) \approx Z g ( x ) ≈ Z 后验均值 E [ Z ∣ X = x ] \mathbb{E}[Z \mid X = x] E [ Z ∣ X = x ] 04 号脚本第 5 部分让 Z Z Z
噪声 σ \sigma σ x = − 2 x = -2 x = − 2 x = − 0.75 x = -0.75 x = − 0.75 x = 0.5 x = 0.5 x = 0.5 x = 1.75 x = 1.75 x = 1.75 x = 3 x = 3 x = 3 0.1 −2.00 / −2.00 −0.81 / −0.78 +0.50 / +0.50 +1.73 / +1.73 +3.00 / +3.00 1 −1.92 / −1.92 −1.02 / −1.03 +0.39 / +0.38 +1.52 / +1.51 +2.80 / +2.82 3 −0.97 / −0.98 −0.63 / −0.61 −0.18 / −0.16 +0.31 / +0.34 +0.82 / +0.86
(图见上方右图。)噪声小时,去噪器几乎是恒等映射(只把 x x x x x x x = 1.75 x = 1.75 x = 1.75 E [ Z ] = − 0.25 \mathbb{E}[Z] = -0.25 E [ Z ] = − 0.25
**第 2 讲的理想向量场、第 3 讲的去噪得分匹配,学的都是这样的后验均值。**当你在第 2 讲看到”一步生成会得到模糊的平均”时,回想这张图:在噪声很大的时刻,最优的预测就是把所有可能性平均起来。
📌 代码 04 :python3 04_conditional_expectation.py。
5. 向量微积分 · Vector calculus
5.1 梯度与雅可比矩阵
标量函数 f : R d → R f: \mathbb{R}^d \to \mathbb{R} f : R d → R 梯度 ∇ f = ( ∂ f / ∂ x 1 , … , ∂ f / ∂ x d ) \nabla f = (\partial f/\partial x_1, \dots, \partial f/\partial x_d) ∇ f = ( ∂ f / ∂ x 1 , … , ∂ f / ∂ x d ) f f f u : R d → R d u: \mathbb{R}^d \to \mathbb{R}^d u : R d → R d 雅可比矩阵 J u J_u J u ( i , j ) (i, j) ( i , j ) ∂ u i / ∂ x j \partial u_i/\partial x_j ∂ u i / ∂ x j i i i i i i u u u u ( x + δ ) ≈ u ( x ) + J u ( x ) δ u(x + \delta) \approx u(x) + J_u(x)\,\delta u ( x + δ ) ≈ u ( x ) + J u ( x ) δ
三种计算方法(05 号脚本第 1 部分):手推公式、自动求导 (PyTorch 的 torch.autograd,给出机器精度的精确值)、有限差分 ∂ f / ∂ x i ≈ ( f ( x + ε e i ) − f ( x − ε e i ) ) / ( 2 ε ) \partial f/\partial x_i \approx (f(x + \varepsilon e_i) - f(x - \varepsilon e_i))/(2\varepsilon) ∂ f / ∂ x i ≈ ( f ( x + ε e i ) − f ( x − ε e i )) / ( 2 ε ) 10 − 10 10^{-10} 1 0 − 10 f = sin ( x 1 ) x 2 2 + e 0.3 x 1 x 2 f = \sin(x_1)x_2^2 + e^{0.3x_1x_2} f = sin ( x 1 ) x 2 2 + e 0.3 x 1 x 2 ( 0.7 , − 1.2 ) (0.7, -1.2) ( 0.7 , − 1.2 )
5.2 散度:单位面积的净流出
向量场的散度 是雅可比矩阵的迹:
div u ( x ) = ∑ i = 1 d ∂ u i ∂ x i ( x ) . \operatorname{div} u(x) = \sum_{i=1}^d \frac{\partial u_i}{\partial x_i}(x). div u ( x ) = i = 1 ∑ d ∂ x i ∂ u i ( x ) . 公式看起来很抽象,它的几何意义却很直观:在 x x x :
div u ( x ) = lim r → 0 1 π r 2 ∮ ∥ y − x ∥ = r u ( y ) ⋅ n ( y ) d s ( d = 2 ) . \operatorname{div}u(x) = \lim_{r \to 0}\frac{1}{\pi r^2}\oint_{\lVert y - x\rVert = r} u(y)\cdot n(y)\,ds\qquad(d = 2). div u ( x ) = r → 0 lim π r 2 1 ∮ ∥ y − x ∥ = r u ( y ) ⋅ n ( y ) d s ( d = 2 ) . 05 号脚本第 2 部分在点 ( 0.7 , − 1.2 ) (0.7, -1.2) ( 0.7 , − 1.2 )
向量场 手算散度 雅可比的迹 通量 / 面积 源 u = x u = x u = x +2 +2 +2.0000 汇 u = − x u = -x u = − x −2 −2 −2.0000 旋转 u = ( − x 2 , x 1 ) u = (-x_2, x_1) u = ( − x 2 , x 1 ) 0 0 0.0000 剪切 u = ( x 2 , 0 ) u = (x_2, 0) u = ( x 2 , 0 ) 0 0 0.0000 u = ( x 1 x 2 , sin x 1 + x 2 2 ) u = (x_1x_2,\ \sin x_1 + x_2^2) u = ( x 1 x 2 , sin x 1 + x 2 2 ) 3 x 2 = − 3.6 3x_2 = -3.6 3 x 2 = − 3.6 −3.6 −3.6000
散度为正,这一点是”源”:流出多于流入,粒子在这里散开 ;为负是”汇”:粒子在这里聚拢 ;为 0:流进多少流出多少(旋转、剪切只是”搬动”,不改变疏密)。
第 2 讲的连续性方程 ∂ t p t = − div ( p t u t ) \partial_t p_t = -\operatorname{div}(p_t u_t) ∂ t p t = − div ( p t u t ) p t u t p_t u_t p t u t
5.3 拉普拉斯算子:周围的平均比中心高多少
Δ f = div ∇ f = ∑ i = 1 d ∂ 2 f ∂ x i 2 \Delta f = \operatorname{div}\nabla f = \sum_{i=1}^d \frac{\partial^2 f}{\partial x_i^2} Δ f = div ∇ f = i = 1 ∑ d ∂ x i 2 ∂ 2 f (海森矩阵的迹)。它的几何意义:在二维里,半径为 r r r f f f
圆周平均 − f ( 中心 ) ≈ r 2 4 Δ f ( 中心 ) . \text{圆周平均} - f(\text{中心}) \approx \frac{r^2}{4}\,\Delta f(\text{中心}). 圆周平均 − f ( 中心 ) ≈ 4 r 2 Δ f ( 中心 ) . Δ f > 0 \Delta f > 0 Δ f > 0 Δ f < 0 \Delta f < 0 Δ f < 0 Δ f = 0 \Delta f = 0 Δ f = 0 05 号脚本第 3 部分对 x 1 2 + x 2 2 x_1^2 + x_2^2 x 1 2 + x 2 2 Δ f = 4 \Delta f = 4 Δ f = 4 x 1 2 − x 2 2 x_1^2 - x_2^2 x 1 2 − x 2 2 Δ f = 0 \Delta f = 0 Δ f = 0 e − ∥ x ∥ 2 / 2 e^{-\lVert x\rVert^2/2} e − ∥ x ∥ 2 /2 Δ f = − 2 \Delta f = -2 Δ f = − 2 ( 1.5 , 0.5 ) (1.5, 0.5) ( 1.5 , 0.5 ) Δ f = + 0.1433 \Delta f = +0.1433 Δ f = + 0.1433
热方程 ∂ t p = σ 2 2 Δ p \partial_t p = \frac{\sigma^2}{2}\Delta p ∂ t p = 2 σ 2 Δ p Δ p < 0 \Delta p < 0 Δ p < 0 Δ p > 0 \Delta p > 0 Δ p > 0 ∂ t p t = − div ( p t u t ) + σ t 2 2 Δ p t \partial_t p_t = -\operatorname{div}(p_t u_t) + \frac{\sigma_t^2}{2}\Delta p_t ∂ t p t = − div ( p t u t ) + 2 σ t 2 Δ p t
5.4 乘积法则与分部积分
乘积法则 :div ( p u ) = ∇ p ⋅ u + p div u \operatorname{div}(p\,u) = \nabla p \cdot u + p\,\operatorname{div}u div ( p u ) = ∇ p ⋅ u + p div u 05 号脚本第 4 部分在一点上验证,两边都是 −1.2097133346。
分部积分 :如果 f g f g f g ± ∞ \pm\infty ± ∞
∫ f ( x ) g ′ ( x ) d x = − ∫ f ′ ( x ) g ( x ) d x . \int f(x)\,g'(x)\,dx = -\int f'(x)\,g(x)\,dx. ∫ f ( x ) g ′ ( x ) d x = − ∫ f ′ ( x ) g ( x ) d x . 它能把导数从一个函数”挪”到另一个函数上(高维的版本是 ∫ f ∂ i g = − ∫ ( ∂ i f ) g \int f\,\partial_i g = -\int(\partial_i f)\,g ∫ f ∂ i g = − ∫ ( ∂ i f ) g ∫ f div v = − ∫ ∇ f ⋅ v \int f\operatorname{div}v = -\int\nabla f\cdot v ∫ f div v = − ∫ ∇ f ⋅ v 05 号脚本取 f = sin x + x f = \sin x + x f = sin x + x g = e − x 2 / 2 g = e^{-x^2/2} g = e − x 2 /2
📌 代码 05 :python3 05_vector_calculus.py。
6. 变量替换与流的瞬时变量替换 · Change of variables
6.1 变量替换公式
设 f : R d → R d f: \mathbb{R}^d \to \mathbb{R}^d f : R d → R d Y = f ( X ) Y = f(X) Y = f ( X )
p Y ( y ) = p X ( f − 1 ( y ) ) ∣ det J f − 1 ( y ) ∣ = p X ( x ) ∣ det J f ( x ) ∣ , x = f − 1 ( y ) . p_Y(y) = p_X\big(f^{-1}(y)\big)\,\big\lvert\det J_{f^{-1}}(y)\big\rvert = \frac{p_X(x)}{\lvert\det J_f(x)\rvert},\qquad x = f^{-1}(y). p Y ( y ) = p X ( f − 1 ( y ) ) det J f − 1 ( y ) = ∣ det J f ( x )∣ p X ( x ) , x = f − 1 ( y ) . 直觉:概率质量守恒。f f f x x x y y y ∣ det J f ( x ) ∣ \lvert\det J_f(x)\rvert ∣ det J f ( x )∣
06 号脚本给了三个层次的例子:
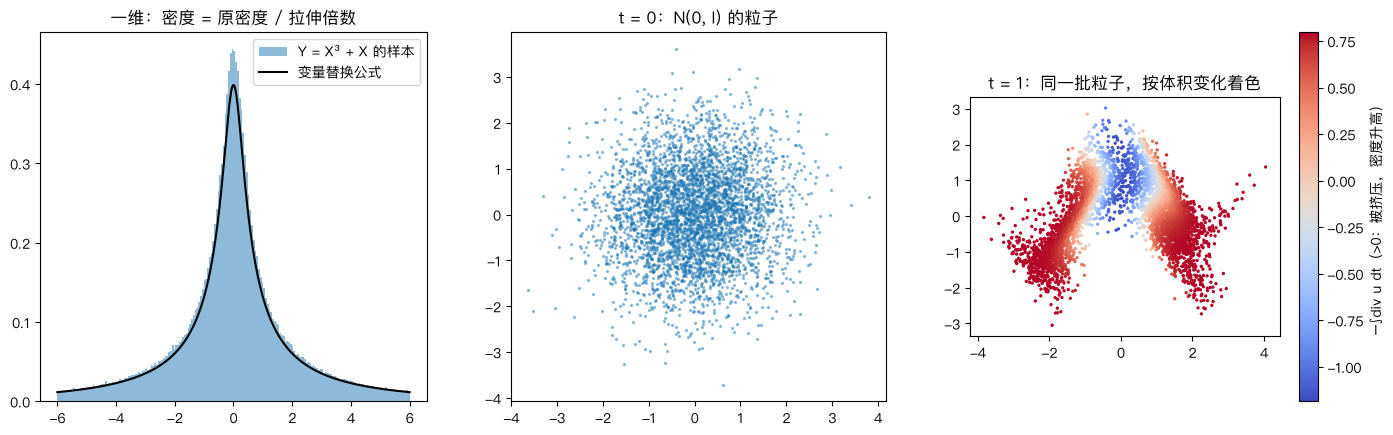
一维 :X ∼ N ( 0 , 1 ) X \sim \mathcal{N}(0, 1) X ∼ N ( 0 , 1 ) Y = X 3 + X Y = X^3 + X Y = X 3 + X f ′ ( x ) = 3 x 2 + 1 f'(x) = 3x^2 + 1 f ′ ( x ) = 3 x 2 + 1 Y Y Y y = 0 y = 0 y = 0 二维线性 :y = A x y = Ax y = A x det A = 1.5 \det A = 1.5 det A = 1.5 A − 1 A^{-1} A − 1 二维非线性 :剪切 y = ( x 1 , x 2 + 1.5 sin x 1 ) y = (x_1, x_2 + 1.5\sin x_1) y = ( x 1 , x 2 + 1.5 sin x 1 ) det = 1 \det = 1 det = 1 y = ( sinh x 1 , x 2 e x 1 ) y = (\sinh x_1, x_2 e^{x_1}) y = ( sinh x 1 , x 2 e x 1 ) cosh x 1 ⋅ e x 1 \cosh x_1 \cdot e^{x_1} cosh x 1 ⋅ e x 1
公式要求 f f f 可逆 :只有这样,”y y y x x x ψ t \psi_t ψ t
6.2 流的瞬时变量替换
流模型的映射 ψ 1 \psi_1 ψ 1 J t = ∂ ψ t ( x 0 ) / ∂ x 0 J_t = \partial\psi_t(x_0)/\partial x_0 J t = ∂ ψ t ( x 0 ) / ∂ x 0 d d t ψ t = u t ( ψ t ) \frac{d}{dt}\psi_t = u_t(\psi_t) d t d ψ t = u t ( ψ t ) x 0 x_0 x 0 d d t J t = J u t ( ψ t ) J t \frac{d}{dt}J_t = J_{u_t}(\psi_t)\,J_t d t d J t = J u t ( ψ t ) J t d d t log det J t = tr ( J t − 1 d d t J t ) \frac{d}{dt}\log\det J_t = \operatorname{tr}\big(J_t^{-1}\tfrac{d}{dt}J_t\big) d t d log det J t = tr ( J t − 1 d t d J t )
d d t log det J t = tr J u t ( ψ t ) = div u t ( X t ) . \frac{d}{dt}\log\det J_t = \operatorname{tr}\,J_{u_t}(\psi_t) = \operatorname{div}u_t(X_t). d t d log det J t = tr J u t ( ψ t ) = div u t ( X t ) . 体积的对数变化率 = 散度。 结合变量替换公式,沿着一条轨迹 X t = ψ t ( X 0 ) X_t = \psi_t(X_0) X t = ψ t ( X 0 )
log p t ( X t ) = log p 0 ( X 0 ) − ∫ 0 t div u s ( X s ) d s . \log p_t(X_t) = \log p_0(X_0) - \int_0^t \operatorname{div}u_s(X_s)\,ds. log p t ( X t ) = log p 0 ( X 0 ) − ∫ 0 t div u s ( X s ) d s . 06 号脚本第 3 部分在一个散度不是常数的二维向量场上验证了两件事:
用有限差分算终点映射的雅可比行列式,和沿轨迹积分散度,两列一致到小数点后 6 位(例如起点 ( 0 , 0 ) (0, 0) ( 0 , 0 ) + 0.757248 +0.757248 + 0.757248 + 0.757248 +0.757248 + 0.757248
让 40 万个 N ( 0 , I ) \mathcal{N}(0, I) N ( 0 , I ) log p 0 ( X 0 ) − ∫ div u \log p_0(X_0) - \int\operatorname{div}u log p 0 ( X 0 ) − ∫ div u t = 1 t = 1 t = 1 ( 1.5 , − 0.5 ) (1.5, -0.5) ( 1.5 , − 0.5 )
上图右:同一批粒子在 t = 1 t = 1 t = 1
6.3 和连续性方程的联系
上面那个式子还可以写成 d d t log p t ( X t ) = − div u t ( X t ) \frac{d}{dt}\log p_t(X_t) = -\operatorname{div}u_t(X_t) d t d log p t ( X t ) = − div u t ( X t ) d d t p t ( X t ) = ∂ t p t + ∇ p t ⋅ u t \frac{d}{dt}p_t(X_t) = \partial_t p_t + \nabla p_t\cdot u_t d t d p t ( X t ) = ∂ t p t + ∇ p t ⋅ u t − p t div u t -p_t\operatorname{div}u_t − p t div u t
∂ t p t = − ∇ p t ⋅ u t − p t div u t = − div ( p t u t ) . \partial_t p_t = -\nabla p_t\cdot u_t - p_t\operatorname{div}u_t = -\operatorname{div}(p_t u_t). ∂ t p t = − ∇ p t ⋅ u t − p t div u t = − div ( p t u t ) . 这正是第 2 讲的连续性方程 。两个视角说的是同一件事:粒子沿向量场走,概率密度就按连续性方程变化。
6.4 为什么不直接学一个可逆映射
既然变量替换公式能精确算出密度,为什么不直接训练一个可逆网络 f θ f_\theta f θ log p X ( f θ − 1 ( y ) ) + log ∣ det J f θ − 1 ∣ \log p_X(f_\theta^{-1}(y)) + \log\lvert\det J_{f_\theta^{-1}}\rvert log p X ( f θ − 1 ( y )) + log ∣ det J f θ − 1 ∣ 归一化流 (normalizing flows)的思路。问题在于行列式:一般的 d × d d\times d d × d d 3 d^3 d 3 06 号脚本第 4 部分):
数据 维数 d d d d 3 d^3 d 3 存下雅可比矩阵(float64) 28×28 灰度图 784 4.8e8 4.9 MB 64×64 彩色图 12,288 1.9e12 1.2 GB 256×256 彩色图 196,608 7.6e15 309 GB
归一化流只能用特殊结构(三角形雅可比、耦合层)让行列式变便宜,这限制了网络的表达能力。连续时间的版本(“连续归一化流”)用 §6.2 的公式把行列式换成了散度的积分,但训练时仍要模拟 ODE、算散度,代价也很大。流匹配(第 2 讲)训练时既不需要行列式、也不需要散度、也不需要模拟 ODE,只做回归 ,这是它能扩展到几十亿参数模型的关键。
📌 代码 06 :python3 06_change_of_variables.py。
工具 本讲 第一次在正课里用到 蒙特卡洛估计、“只需要会采样” §1.4–1.5 第 2 讲:流匹配损失是对 ( t , z , ϵ ) (t, z, \epsilon) ( t , z , ϵ ) 重参数化、独立高斯相加 §2.1、§2.3 第 1 讲 §3.5(理想向量场);第 2 讲高斯概率路径 x t = α t z + β t ϵ x_t = \alpha_t z + \beta_t\epsilon x t = α t z + β t ϵ 狄拉克 δ §2.4 第 2 讲:条件概率路径在 t = 1 t = 1 t = 1 δ z \delta_z δ z 高斯的得分函数 §2.5 第 1 讲 §5.3(朗之万动力学);第 3 讲条件得分 贝叶斯公式、后验 §3 第 2 讲:边缘向量场 = 条件向量场按后验 p ( z ∣ x ) p(z \mid x) p ( z ∣ x ) 采样容易、密度难 §3.4 第 2 讲:边缘概率路径能采样、算不出密度 回归 = 条件期望 §4.2 第 2 讲:网络学到边缘向量场;第 3 讲:去噪器 = 后验均值 均方误差分解 §4.3 第 2 讲定理 12:条件流匹配损失 = 流匹配损失 + 常数;第 3 讲定理 22 塔式法则 §4.4 第 2 讲边缘化技巧的证明 散度、连续性方程 §5.2、§6.3 第 2 讲定理 11 拉普拉斯算子、热方程 §5.3 第 3 讲 Fokker–Planck 方程 分部积分 §5.4 第 3 讲;原课讲义附录 B 变量替换、瞬时变量替换 §6 第 2 讲连续性方程的直觉;第 5 讲 VAE 的讨论
8. 小结 · Summary
期望 是使平均平方距离最小的常数;蒙特卡洛 用样本平均估计期望,误差 Var f / N \sqrt{\operatorname{Var}f/N} Var f / N 高斯 :重参数化 x = μ + σ ϵ x = \mu + \sigma\epsilon x = μ + σ ϵ − ( x − μ ) / σ 2 -(x - \mu)/\sigma^2 − ( x − μ ) / σ 2 d \sqrt{d} d 联合、边缘、条件 :边缘 = 对另一个变量积分;条件 = 固定后重新归一化;贝叶斯公式把条件反过来。p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z p(x) = \int p(x\mid z)p(z)dz p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z 条件期望 E [ X ∣ Y = y ] \mathbb{E}[X \mid Y = y] E [ X ∣ Y = y ] E [ X ∣ Y ] \mathbb{E}[X \mid Y] E [ X ∣ Y ] 用均方误差回归,学到的是条件期望 ;损失的最小值是不可约的条件方差,不是 0。均方误差分解 :E ∥ X − g ( Y ) ∥ 2 = 常数 + E ∥ E [ X ∣ Y ] − g ( Y ) ∥ 2 \mathbb{E}\lVert X - g(Y)\rVert^2 = \text{常数} + \mathbb{E}\lVert\mathbb{E}[X\mid Y] - g(Y)\rVert^2 E ∥ X − g ( Y ) ∥ 2 = 常数 + E ∥ E [ X ∣ Y ] − g ( Y ) ∥ 2 散度 = 单位体积的净流出;拉普拉斯算子 = 周围平均比中心高多少;乘积法则 和分部积分 是推导连续性方程、Fokker–Planck 方程的基本工具。变量替换 :密度 = 原密度 / 体积放大倍数。对流而言,d d t log p t ( X t ) = − div u t ( X t ) \frac{d}{dt}\log p_t(X_t) = -\operatorname{div}u_t(X_t) d t d log p t ( X t ) = − div u t ( X t )
9. 常见误区 · Common pitfalls
“密度就是概率,所以不能大于 1。” 密度可以任意大(N ( z , 0.001 2 ) \mathcal{N}(z, 0.001^2) N ( z , 0.00 1 2 ) z z z “高斯的样本大多在均值附近。” 低维时是,高维时完全不是:样本集中在离均值约 σ d \sigma\sqrt{d} σ d ”E [ X ∣ Y ] \mathbb{E}[X \mid Y] E [ X ∣ Y ] 它是 Y Y Y E [ X ∣ Y = y ] \mathbb{E}[X \mid Y = y] E [ X ∣ Y = y ] y y y “回归的损失降到 0 才算训练好。” 只要目标里有与输入无关的噪声,最小损失就是 E [ Var ( X ∣ Y ) ] > 0 \mathbb{E}[\operatorname{Var}(X\mid Y)] > 0 E [ Var ( X ∣ Y )] > 0 “对嘈杂的目标做回归,学到的东西也是嘈杂的。” 只要用均方误差,学到的是目标的条件均值,噪声被平均掉了(§4.2、§4.3)。“散度为 0 的向量场不移动粒子。” 旋转场的散度为 0,但粒子在转圈。散度为 0 只表示”不改变疏密”(§5.2)。“变量替换公式对任何映射都成立。” 它要求映射可逆(且可微);多对一的映射要把所有原像的贡献加起来。“算得分函数要先算出归一化常数。” 不需要:常数的对数在求梯度时消失(§2.5)。
10. 练习 · Exercises
练习 1(期望的最小二乘刻画) 。证明 E ∥ X − z ∥ 2 = tr Cov ( X ) + ∥ z − E X ∥ 2 \mathbb{E}\lVert X - z\rVert^2 = \operatorname{tr}\operatorname{Cov}(X) + \lVert z - \mathbb{E}X\rVert^2 E ∥ X − z ∥ 2 = tr Cov ( X ) + ∥ z − E X ∥ 2 E ∣ X − z ∣ \mathbb{E}\lvert X - z\rvert E ∣ X − z ∣ z z z
参考答案 展开 ∥ X − E X + E X − z ∥ 2 \lVert X - \mathbb{E}X + \mathbb{E}X - z\rVert^2 ∥ X − E X + E X − z ∥ 2 tr Cov ( X ) \operatorname{tr}\operatorname{Cov}(X) tr Cov ( X ) z z z d d z E ∣ X − z ∣ = P ( X < z ) − P ( X > z ) \frac{d}{dz}\mathbb{E}\lvert X - z\rvert = P(X < z) - P(X > z) d z d E ∣ X − z ∣ = P ( X < z ) − P ( X > z ) P ( X < z ) = 1 / 2 P(X < z) = 1/2 P ( X < z ) = 1/2
练习 2(高斯相加) 。设 z ∼ N ( m , s 2 I d ) z \sim \mathcal{N}(m, s^2 I_d) z ∼ N ( m , s 2 I d ) ϵ ∼ N ( 0 , I d ) \epsilon \sim \mathcal{N}(0, I_d) ϵ ∼ N ( 0 , I d ) x t = α t z + β t ϵ x_t = \alpha_t z + \beta_t\epsilon x t = α t z + β t ϵ x t x_t x t p data = ∑ k w k N ( m k , s k 2 I ) p_{\text{data}} = \sum_k w_k\,\mathcal{N}(m_k, s_k^2 I) p data = ∑ k w k N ( m k , s k 2 I ) x t x_t x t α t = t \alpha_t = t α t = t β t = 1 − t \beta_t = 1 - t β t = 1 − t x t x_t x t d = 1 d = 1 d = 1
参考答案 (a) N ( α t m , ( α t 2 s 2 + β t 2 ) I ) \mathcal{N}(\alpha_t m, (\alpha_t^2 s^2 + \beta_t^2)I) N ( α t m , ( α t 2 s 2 + β t 2 ) I ) w k w_k w k ∑ k w k N ( α t m k , ( α t 2 s k 2 + β t 2 ) I ) \sum_k w_k\,\mathcal{N}(\alpha_t m_k, (\alpha_t^2 s_k^2 + \beta_t^2)I) ∑ k w k N ( α t m k , ( α t 2 s k 2 + β t 2 ) I ) oracle_fields.py 里的 marginal(t)。(c) 方差 v ( t ) = t 2 s 2 + ( 1 − t ) 2 v(t) = t^2 s^2 + (1 - t)^2 v ( t ) = t 2 s 2 + ( 1 − t ) 2 2 t s 2 − 2 ( 1 − t ) = 0 2ts^2 - 2(1 - t) = 0 2 t s 2 − 2 ( 1 − t ) = 0 t ⋆ = 1 / ( 1 + s 2 ) t^\star = 1/(1 + s^2) t ⋆ = 1/ ( 1 + s 2 ) s 2 / ( 1 + s 2 ) s^2/(1 + s^2) s 2 / ( 1 + s 2 ) s = 0.4 s = 0.4 s = 0.4 t ⋆ ≈ 0.862 t^\star \approx 0.862 t ⋆ ≈ 0.862 s 2 = 0.16 s^2 = 0.16 s 2 = 0.16 02 号脚本第 3 部分的表里 t = 0.75 t = 0.75 t = 0.75 t = 1 t = 1 t = 1
练习 3(高斯后验) 。设 Z ∼ N ( μ 0 , τ 2 ) Z \sim \mathcal{N}(\mu_0, \tau^2) Z ∼ N ( μ 0 , τ 2 ) X = a Z + σ ϵ X = aZ + \sigma\epsilon X = a Z + σ ϵ p ( z ∣ x ) p(z \mid x) p ( z ∣ x ) μ 0 = 0 \mu_0 = 0 μ 0 = 0 τ = a = 1 \tau = a = 1 τ = a = 1
参考答案 ( Z , X ) (Z, X) ( Z , X ) Cov ( Z , X ) = a τ 2 \operatorname{Cov}(Z, X) = a\tau^2 Cov ( Z , X ) = a τ 2 Var X = a 2 τ 2 + σ 2 \operatorname{Var}X = a^2\tau^2 + \sigma^2 Var X = a 2 τ 2 + σ 2 E [ Z ∣ x ] = μ 0 + a τ 2 a 2 τ 2 + σ 2 ( x − a μ 0 ) \mathbb{E}[Z\mid x] = \mu_0 + \frac{a\tau^2}{a^2\tau^2 + \sigma^2}(x - a\mu_0) E [ Z ∣ x ] = μ 0 + a 2 τ 2 + σ 2 a τ 2 ( x − a μ 0 ) Var [ Z ∣ x ] = τ 2 − a 2 τ 4 a 2 τ 2 + σ 2 = τ 2 σ 2 a 2 τ 2 + σ 2 \operatorname{Var}[Z\mid x] = \tau^2 - \frac{a^2\tau^4}{a^2\tau^2 + \sigma^2} = \frac{\tau^2\sigma^2}{a^2\tau^2 + \sigma^2} Var [ Z ∣ x ] = τ 2 − a 2 τ 2 + σ 2 a 2 τ 4 = a 2 τ 2 + σ 2 τ 2 σ 2 μ 0 = 0 \mu_0 = 0 μ 0 = 0 τ = a = 1 \tau = a = 1 τ = a = 1 x 1 + σ 2 \frac{x}{1 + \sigma^2} 1 + σ 2 x σ 2 1 + σ 2 \frac{\sigma^2}{1 + \sigma^2} 1 + σ 2 σ 2 oracle_fields.py 里”每个成分内的 E [ z ∣ x , k ] \mathbb{E}[z \mid x, k] E [ z ∣ x , k ] a = t a = t a = t σ = 1 − t \sigma = 1 - t σ = 1 − t
练习 4(均方误差分解的应用) 。设 Y Y Y X X X g θ g_\theta g θ ∇ θ E ∥ X − g θ ( Y ) ∥ 2 = ∇ θ E ∥ E [ X ∣ Y ] − g θ ( Y ) ∥ 2 \nabla_\theta\,\mathbb{E}\lVert X - g_\theta(Y)\rVert^2 = \nabla_\theta\,\mathbb{E}\lVert\mathbb{E}[X\mid Y] - g_\theta(Y)\rVert^2 ∇ θ E ∥ X − g θ ( Y ) ∥ 2 = ∇ θ E ∥ E [ X ∣ Y ] − g θ ( Y ) ∥ 2
参考答案 由 §4.3 的分解,两者只差一个与 θ \theta θ ( y i , x i ) (y_i, x_i) ( y i , x i ) E [ X ∣ Y ] \mathbb{E}[X\mid Y] E [ X ∣ Y ] X X X E [ X ∣ Y ] \mathbb{E}[X\mid Y] E [ X ∣ Y ]
练习 5(散度) 。计算 (a) u ( x ) = A x u(x) = Ax u ( x ) = A x A A A d × d d\times d d × d u ( x ) = − ( x − μ ) / σ 2 u(x) = -(x - \mu)/\sigma^2 u ( x ) = − ( x − μ ) / σ 2 u ( x ) = ω ( − x 2 , x 1 ) u(x) = \omega(-x_2, x_1) u ( x ) = ω ( − x 2 , x 1 )
参考答案 (a) tr A \operatorname{tr}A tr A − d / σ 2 -d/\sigma^2 − d / σ 2 ∂ ( − ω x 2 ) / ∂ x 1 + ∂ ( ω x 1 ) / ∂ x 2 = 0 \partial(-\omega x_2)/\partial x_1 + \partial(\omega x_1)/\partial x_2 = 0 ∂ ( − ω x 2 ) / ∂ x 1 + ∂ ( ω x 1 ) / ∂ x 2 = 0 log det J \log\det J log det J
练习 6(拉普拉斯算子的平均值性质) 。用二阶泰勒展开证明二维中”圆周平均 − f ( c ) ≈ r 2 4 Δ f ( c ) - f(c) \approx \frac{r^2}{4}\Delta f(c) − f ( c ) ≈ 4 r 2 Δ f ( c )
参考答案 f ( c + r n ) ≈ f ( c ) + r ∇ f ⋅ n + r 2 2 n ⊤ H n f(c + r n) \approx f(c) + r\nabla f\cdot n + \frac{r^2}{2}n^\top H n f ( c + r n ) ≈ f ( c ) + r ∇ f ⋅ n + 2 r 2 n ⊤ H n n = ( cos a , sin a ) n = (\cos a, \sin a) n = ( cos a , sin a ) n 1 2 ‾ = n 2 2 ‾ = 1 2 \overline{n_1^2} = \overline{n_2^2} = \frac{1}{2} n 1 2 = n 2 2 = 2 1 n 1 n 2 ‾ = 0 \overline{n_1n_2} = 0 n 1 n 2 = 0 r 2 2 ⋅ 1 2 ( H 11 + H 22 ) = r 2 4 Δ f \frac{r^2}{2}\cdot\frac{1}{2}(H_{11} + H_{22}) = \frac{r^2}{4}\Delta f 2 r 2 ⋅ 2 1 ( H 11 + H 22 ) = 4 r 2 Δ f d d d r 2 2 d Δ f \frac{r^2}{2d}\Delta f 2 d r 2 Δ f
练习 7(线性流的瞬时变量替换) 。对 u t ( x ) = − θ x u_t(x) = -\theta x u t ( x ) = − θ x d d d X 0 ∼ N ( 0 , I ) X_0 \sim \mathcal{N}(0, I) X 0 ∼ N ( 0 , I ) X t X_t X t log p t ( X t ) = log p 0 ( X 0 ) − ∫ 0 t div u \log p_t(X_t) = \log p_0(X_0) - \int_0^t\operatorname{div}u log p t ( X t ) = log p 0 ( X 0 ) − ∫ 0 t div u
参考答案 (a) X t = e − θ t X 0 ∼ N ( 0 , e − 2 θ t I ) X_t = e^{-\theta t}X_0 \sim \mathcal{N}(0, e^{-2\theta t}I) X t = e − θ t X 0 ∼ N ( 0 , e − 2 θ t I ) div u = − θ d \operatorname{div}u = -\theta d div u = − θ d log p t ( X t ) = log p 0 ( X 0 ) + θ d t \log p_t(X_t) = \log p_0(X_0) + \theta d t log p t ( X t ) = log p 0 ( X 0 ) + θ d t log p t ( X t ) = − ∥ X t ∥ 2 2 e − 2 θ t − d 2 log ( 2 π e − 2 θ t ) = − ∥ X 0 ∥ 2 2 − d 2 log 2 π + θ d t \log p_t(X_t) = -\frac{\lVert X_t\rVert^2}{2e^{-2\theta t}} - \frac{d}{2}\log(2\pi e^{-2\theta t}) = -\frac{\lVert X_0\rVert^2}{2} - \frac{d}{2}\log 2\pi + \theta d t log p t ( X t ) = − 2 e − 2 θ t ∥ X t ∥ 2 − 2 d log ( 2 π e − 2 θ t ) = − 2 ∥ X 0 ∥ 2 − 2 d log 2 π + θ d t e θ d t e^{\theta d t} e θ d t
练习 8(编程:分布路径上的方差) 。修改 02_gaussians.py 第 3 部分,把调度换成 α t = t \alpha_t = t α t = t β t = 1 − t \beta_t = \sqrt{1 - t} β t = 1 − t t = 0.5 t = 0.5 t = 0.5
参考答案(提示) 方差 α t 2 s 2 + β t 2 = t 2 s 2 + ( 1 − t ) \alpha_t^2 s^2 + \beta_t^2 = t^2 s^2 + (1 - t) α t 2 s 2 + β t 2 = t 2 s 2 + ( 1 − t ) t = 0.5 t = 0.5 t = 0.5 0.04 + 0.5 = 0.54 0.04 + 0.5 = 0.54 0.04 + 0.5 = 0.54 0.04 + 0.25 = 0.29 0.04 + 0.25 = 0.29 0.04 + 0.25 = 0.29 1 − t \sqrt{1 - t} 1 − t t t t
11. 延伸阅读 · Further reading
原课讲义附录 A (概率回顾)和附录 B (Fokker–Planck 方程的证明,用到本讲 §5 的分部积分和散度)。概率论入门 :Blitzstein & Hwang, Introduction to Probability (第 2 版,CRC,免费在线),第 7 章(联合分布)和第 9 章(条件期望)讲得非常直观。多元高斯与条件化 :Bishop, Pattern Recognition and Machine Learning ,§2.3(高斯的边缘与条件分布,包括练习 3 的公式)。变量替换与归一化流 :Papamakarios et al., Normalizing Flows for Probabilistic Modeling and Inference (JMLR 2021),第 2 节;瞬时变量替换见 Chen et al., Neural Ordinary Differential Equations (NeurIPS 2018)的定理 1。向量微积分的几何直觉 :Schey, Div, Grad, Curl, and All That (Norton),薄薄一本,用流体的语言讲散度、通量和散度定理。本仓库的相关讲义 :CMU10-423 前置讲 P2 概率工具箱 从离散时间扩散和 VAE 的角度讲了 KL 散度、ELBO 和重参数化,可与本讲互补。
12. 下一篇预告 · Next
前置讲 P2 讲这门课的代码里用到的 PyTorch 工具:张量的形状与广播(以及一个在流匹配代码里极其常见的形状 bug)、自动求导与三种算得分函数的方法、散度的精确计算与随机估计、nn.Module 与训练循环、可复现性,以及怎样画向量场。读完 P2,就可以进入第 2 讲:用本讲的条件期望和均方误差分解,从零推导并实现流匹配。