对应 Maps to:MIT 6.S184 Generative AI with Stochastic Differential Equations(IAP 2026),Lecture 3-B · 23-Jan-2026 · Classifier-free Guidance;Lab 3 中条件生成与无分类器引导的部分(原课用 MNIST,这里换成代码画出来的”像素数字”)。 阅读材料:原课讲义 Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(2026 版,arXiv:2506.02070)第 5 章;Lecture 3 slides 的后半部分;原始论文 Dhariwal & Nichol (2021) Diffusion Models Beat GANs on Image Synthesis(分类器引导)、Ho & Salimans (2021/2022) Classifier-Free Diffusion Guidance。 依据说明:本讲以原课讲义第 5 章为主线:条件生成与引导向量场、分类器引导(贝叶斯公式 + 放大系数)、无分类器引导及其训练算法(Algorithm 5)、扩散模型的引导。“带标签的高斯混合上的闭式引导场""CFG 的样本 vs 倾斜分布的精确样本""一维两高斯的 CFG""标签丢弃概率的影响""像素数字上的 CFG(含’画错的笔画’)“等实验是本讲义补充的。其中”CFG 采样的不是倾斜分布”有近年的论文支持(§3.2);像素数字的实验结果依赖于数据的设计,§4 如实说明。 配套代码 Code:
code/lecture04/(4 个脚本 + 2 个模块;PyTorch + matplotlib;每个脚本 3–35 秒,都完整运行过) 预计阅读时间:4 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 写出引导向量场 的训练目标,解释为什么”只把提示当作额外输入”(vanilla guidance)得到的是 ,而 本身往往”不够像 ”。
- 用贝叶斯公式推导 ,理解分类器引导和它为什么需要一个”认识噪声”的分类器。
- 推导无分类器引导(CFG),实现它的训练(标签丢弃,Algorithm 5)和采样。
- 说清 CFG 的代价:提示遵循度上升、多样性下降、离数据分布越来越远;知道 CFG 不是在倾斜分布 里采样。
- 在一个图像数据集上训练 CFG 模型,并用分类器准确率、风格多样性、Fréchet 距离评估引导强度 的影响。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 条件流匹配、边缘化技巧、Algorithm 3 | 第 2 讲 §3–§4 |
| 得分函数、换算公式 | 第 3 讲 §1–§2 |
| 贝叶斯公式、后验 | 前置讲 P1 §3 |
| 条件期望 = 回归的最优解 | P1 §4.2 |
本讲的”提示”是类别标签。真实的文生图模型怎样把一段文字变成网络的输入(文本编码器、交叉注意力)是第 5 讲的内容。
0.3 本讲地图 Map
§1  条件生成:引导向量场 u_t(x|y);为什么只这样做不够            ← 代码 01
§2  分类器引导:贝叶斯公式;放大分类器项;含噪分类器              ← 代码 01
§3  无分类器引导:推导、训练(Algorithm 5)、它采样的到底是什么    ← 代码 02、03
§4  图像上的 CFG:像素数字                                        ← 代码 04
§5  全景:引导在大模型里
§6  小结   §7  常见误区   §8  练习   §9  延伸阅读   §10 下一讲预告
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 提示(prompt):类别标签、一段文字的嵌入…… | |
| 空提示(“什么都不指定”), | |
| 条件数据分布 | |
| 引导向量场(guided vector field):沿 走的边缘向量场。注意和第 2 讲的条件向量场 区分:那里的条件是一个数据点 ,这里是一个提示 | |
| 含噪分类器:给定时刻 的带噪样本 ,它的提示是 的概率 | |
| 换算公式里得分的系数 (CondOT:,第 3 讲 §2.1) | |
| 引导强度(guidance scale); 是不引导的条件生成 | |
| 倾斜分布 |
0.5 本讲的玩具数据:带标签的六峰圆环
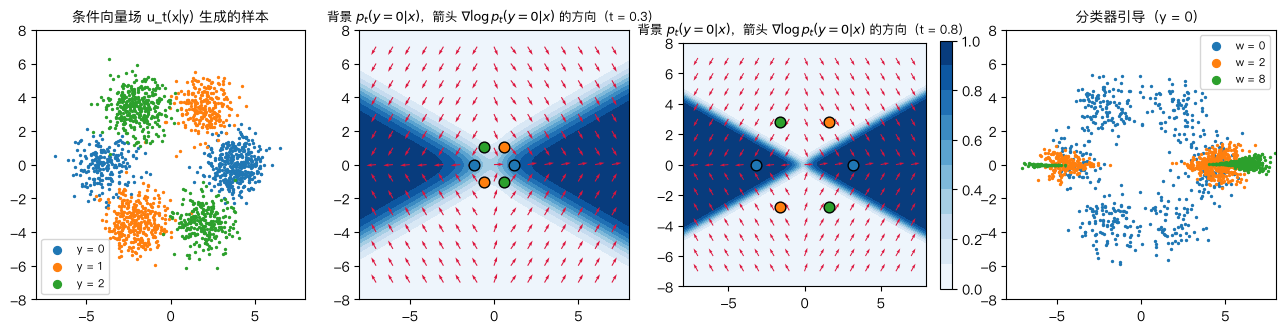
(最左:六个峰排成半径 4 的圆,标准差 0.9,三种颜色是三个类别,相邻的峰属于不同类别。中间两张:含噪分类器 (背景)和它的梯度方向(箭头)。最右:分类器引导的样本。)
类别 0 = 0° 和 180° 的两个峰,类别 1 = 60° 和 240°,类别 2 = 120° 和 300°。六个峰的权重是 0.22、0.12、0.20、0.13、0.18、0.15,所以 ,类别 0 内两个峰的比例是 0.63 : 0.37。这样设计是为了:
- 相邻的峰相距约 4.4 个标准差,类别之间有一片”说不清属于谁”的区域,引导”把样本推离别的类别”的效果看得出来;
- 同一类别的两个峰在圆的两侧,可以观察引导会不会改变类内的比例(多样性的一种)。
它仍然是高斯混合,所以 、、 都有闭式解(guidance_lib.GuidanceOracle),学到的东西可以和”真相”逐点比较。
1. 条件生成 · Conditional generation
1.1 从”随便画一张”到”画一只猫”
到第 3 讲为止,我们的模型只会从 里随便采一个样本。真正有用的生成模型要能按提示生成:给一个提示 (“一只戴帽子的猫”),从条件分布 中采样。第 1 讲 §1.6 已经把这件事写成了”条件生成 = 从 采样”。
原课讲义把这叫作引导(guidance)。名字的来历是:提示”引导”着生成过程走向它描述的那类样本。
1.2 引导向量场,以及最直接的训练方法
对每个固定的 , 就是一个普通的数据分布,第 2 讲的一切都可以照搬:
- 条件概率路径 不变(它只依赖于数据点 ,不依赖于 );
- 边缘路径变成 ;
- 它的边缘向量场就是引导向量场 。
训练时把 作为网络的额外输入,对 对做条件流匹配:
注意回归目标 只依赖于 。网络看到 ,学到的是目标在给定 时的条件期望(P1 §4.2),正好是 。原课讲义把这种做法叫作 vanilla guidance(“普通的引导”)。
01 号脚本第 1 部分用闭式的 采样(欧拉 200 步),与真实的 比较:
| 准确率 | 平均 | 平均半径 | 类内比例 | 峰内散度 | 能量距离 | ||
|---|---|---|---|---|---|---|---|
| :真实 | 97.4% | 0.961 | 78.0% | 4.10 | 0.62 | 1.00 | −0.002 |
| :生成 | 97.7% | 0.962 | 76.7% | 4.05 | 0.65 | 1.00 | 0.004 |
| :真实 | 97.0% | 0.957 | 75.9% | 4.09 | 0.40 | 1.00 | −0.001 |
| :生成 | 96.6% | 0.952 | 73.8% | 4.09 | 0.41 | 1.02 | −0.002 |
| :真实 | 97.6% | 0.960 | 76.7% | 4.10 | 0.56 | 1.00 | 0.001 |
| :生成 | 97.8% | 0.964 | 77.7% | 4.09 | 0.58 | 1.00 | −0.002 |
(“准确率”= 贝叶斯最优分类器 判为 的比例;“类内比例”= 落在该类第一个峰附近的比例。)
条件向量场给出的就是 :每一项指标都和真实样本一致。
1.3 为什么这样还不够
注意表里的”准确率”不是 100%。类别之间本来就有重叠,真实样本里也有 2–3% 被贝叶斯最优分类器判给别的类,只有约 77% 的样本”非常确定”()。 本身就包含”不太像 “的样本。
原课讲义指出,在图像上也是这样:用 vanilla guidance 训练出来的模型,生成的图像常常和提示对不上。原因有两个:一是数据本身就”嘈杂”(网上的图文对里,文字常常只描述了图像的一部分);二是网络学得不完美,条件信号 对输出的影响被低估了。人们想要的其实是”比真实数据更像 “的样本。这就需要某种办法放大提示的作用。
📌 代码 01(第 1 部分):
python3 01_conditional_and_bayes.py。
2. 分类器引导 · Classifier guidance
2.1 贝叶斯公式:条件得分 = 无条件得分 + 分类器的梯度
对时刻 的边缘路径用贝叶斯公式:。取对数、对 求梯度( 与 无关,消失了):
其中 是一个含噪分类器:给它一个时刻 的带噪样本 ,它判断这个样本的提示是什么。
再用第 3 讲的换算公式 (条件版本的 系数相同),把得分换成向量场:
含义:引导向量场 = 无条件向量场 + 一个”把粒子推向 类”的修正,修正的方向是含噪分类器的梯度,大小由换算系数 决定。
01 号脚本第 2 部分用 autograd 对闭式的 求导(一个独立的算法),在 核对两个等式:最大差都在 量级。
上一页图的中间两张画出了 和它的梯度方向。值得注意的是它的形状:类别 0 的后验在一个”蝴蝶结”形的楔形区域里接近 1(沿着 0° 和 180° 方向向外延伸),而不是只在两个峰附近。离圆心越远,离相邻的别类峰相对越远,属于类别 0 的把握越大。§2.2 会看到这个形状的后果。
2.2 放大分类器项
既然条件向量场 = 无条件 + 分类器项,一个自然的想法是把分类器项放大(Dhariwal & Nichol 2021):
在得分的语言里,这相当于把 换成 :分类器”说话的分量”更重了。原课讲义强调,这已经不再是某个数据分布的向量场,它是一个启发式。
01 号脚本第 3 部分(类别 0,欧拉 200 步):
| 引导强度 | 准确率 | 平均半径 | 类内比例 | 峰内散度 | 与 的能量距离 | |
|---|---|---|---|---|---|---|
| (无条件) | 34.3% | 26.6% | 4.09 | 0.48 | 2.71 | 0.676 |
| (= 条件场) | 97.6% | 77.3% | 4.08 | 0.61 | 1.00 | −0.001 |
| 100% | 99.8% | 4.47 | 0.69 | 0.82 | 0.147 | |
| 100% | 100% | 5.08 | 0.77 | 1.04 | 0.871 | |
| 100% | 100% | 5.98 | 0.86 | 1.64 | 2.700 |
三个现象:
- 提示遵循度迅速饱和: 时 99.8% 的样本”非常确定”是类别 0。代价是样本不再服从 。
- 样本被推向”最不像别的类”的地方:平均半径从 4.1 增大到 6.0。这正是蝴蝶结形后验的后果:引导沿着 走,而它指向楔形区域的外侧。 时峰内散度 0.82(峰被压窄、样本更”典型”); 再大时整团样本被推离峰中心,散度又变大。
- 类内的多样性也被改变:类别 0 的两个峰本应是 0.63 : 0.37, 时变成 0.86 : 0.14。第一个峰的邻居权重较小(0.12、0.15),第二个峰的邻居较大(0.20、0.18),所以第一个峰附近 更高,引导就更偏爱它。在图像上,这相当于”猫”这个提示只生成某一种最典型的猫。
2.3 分类器必须”认识噪声”
公式里的分类器是 :它的输入是时刻 的带噪样本。如果偷懒,拿一个只在干净数据上训练的分类器 在所有时刻使用,会怎样?01 号脚本第 3 部分的最后两行( 在 时按 计算以免除以 0):
| 准确率 | 平均半径 | 类内比例 | 峰内散度 | 能量距离 | |
|---|---|---|---|---|---|
| ,干净分类器 | 100% | 4.78 | 0.53 | 0.69 | 0.484 |
| ,干净分类器 | 100% | 5.39 | 0.53 | 1.11 | 0.934 |
时也不再给出 (能量距离 0.48)。 较小时粒子还是一团噪声,干净分类器对这种输入给出的梯度和真正的 相去甚远。这就是 Dhariwal & Nichol(2021)要专门在带噪图像上训练分类器的原因。
2.4 分类器引导的麻烦
分类器引导在 2021 年第一次让扩散模型在 ImageNet 上超过了 GAN,但它有明显的缺点:
- 要另外训练一个分类器,而且必须在所有噪声水平上训练(现成的图像分类器不能用);
- 对文生图来说,“分类器”要能判断任意一段文字和一张带噪图像是否匹配,这本身就是一个很难的模型;
- 沿分类器梯度走,有点像对分类器做”对抗攻击”:网络的梯度可能指向”让分类器高兴、但人看来没有意义”的方向。
能不能不要分类器?
📌 代码 01(第 2、3 部分)。
3. 无分类器引导 · Classifier-free guidance
3.1 推导:隐式的分类器
关键的一步只是把 §2.1 的等式反过来用:
分类器的梯度本来就藏在条件场和无条件场之差里。代入分类器引导:
这就是无分类器引导(classifier-free guidance, CFG;Ho & Salimans 2021)。只需要条件场 和无条件场 ,不需要任何分类器。直觉:从无条件场出发,沿着”条件减去无条件”的方向多走 倍。 是普通的条件生成, 是无条件生成, 是”外推”。
一个网络学两个场。CFG 不需要训练两个网络:把”空提示” 当作一个额外的类别,训练时以概率 把标签换成 。被换掉标签的样本,网络能看到的只有 ,它学到的最优预测就是对所有 平均的无条件场(P1 §4.2)。这就是原课讲义的 Algorithm 5:
Algorithm 5  无分类器引导的训练(高斯路径)
输入:带提示的数据集 {(z, y)},网络 u^θ,丢弃概率 p_uncond
for 每个小批量:
    抽 (z, y);以概率 p_uncond 令 y ← ∅
    抽 t ~ Unif[0, 1],ε ~ N(0, I);x ← α_t z + β_t ε
    L(θ) ← ‖u^θ_t(x | y) − (α̇_t z + β̇_t ε)‖²
    θ ← 梯度更新(L(θ))
采样时:ũ_t(x) = (1 − w) u^θ_t(x | ∅) + w u^θ_t(x | y),用欧拉法从 t = 0 模拟到 1
对应的 Python(guidance_lib.py,节选):
drop = torch.rand(batch, generator=g) < p_uncond
y = torch.where(drop, torch.full_like(y, model.n_classes), y)   # 第 C 个"类别"就是 ∅
...
# 采样时把条件和无条件拼成一个批,一次前向算完
out = model(torch.cat([x, x]), t, torch.cat([y, null]))
cond, uncond = out[:n], out[n:]
return uncond + w * (cond - uncond)
最后两行也说明了 CFG 的计算代价:每一步要算两次前向(条件和无条件),实际实现里把它们拼成一个两倍大小的批。
CFG 不依赖于参数化。如果网络预测的是噪声或得分,把同样的组合用在 或 上:。因为第 3 讲的换算公式对预测值是仿射的(,条件和无条件用的是同一个 和同一组系数),在哪种参数化里做 CFG 都得到同一个向量场(练习 2)。原课讲义在扩散模型的部分就是这样写的。
3.2 CFG 采样的到底是什么分布?
在得分的语言里,CFG 的场对应
每个时刻都是一个”倾斜”过的分布的得分。于是很容易以为:CFG 采样到的是倾斜分布
在二维里, 可以在网格上精确采样(guidance_lib.tilted_sample)。02 号脚本先扫描 (第 1 部分,闭式的 CFG 场;结果和 §2.2 的分类器引导一致,因为两者在闭式的场下完全相同),再把 CFG 的样本和 的精确样本放在一起比(第 2 部分):
| 能量距离 CFG vs | 地板( vs ) | 半径 CFG / | 类内比例 CFG / | 峰内散度 CFG / | CFG / | |
|---|---|---|---|---|---|---|
| 1 | 0.002 | +0.010 | 4.08 / 4.13 | 0.63 / 0.64 | 1.00 / 0.98 | 77% / 79% |
| 1.5 | 0.043 | −0.002 | 4.29 / 4.11 | 0.66 / 0.63 | 0.84 / 0.97 | 97% / 80% |
| 2 | 0.155 | +0.001 | 4.47 / 4.13 | 0.69 / 0.63 | 0.82 / 0.95 | 99.7% / 81% |
| 3 | 0.519 | −0.002 | 4.80 / 4.17 | 0.75 / 0.62 | 0.90 / 0.94 | 100% / 83% |
| 5 | 1.359 | −0.002 | 5.34 / 4.15 | 0.80 / 0.62 | 1.20 / 0.93 | 100% / 83% |
| 8 | 2.696 | +0.000 | 5.98 / 4.16 | 0.87 / 0.64 | 1.64 / 0.90 | 100% / 85% |
(地板本身有约 的波动:类别 0 的两个峰在圆的两侧,峰的比例的抽样误差对能量距离影响很大。)
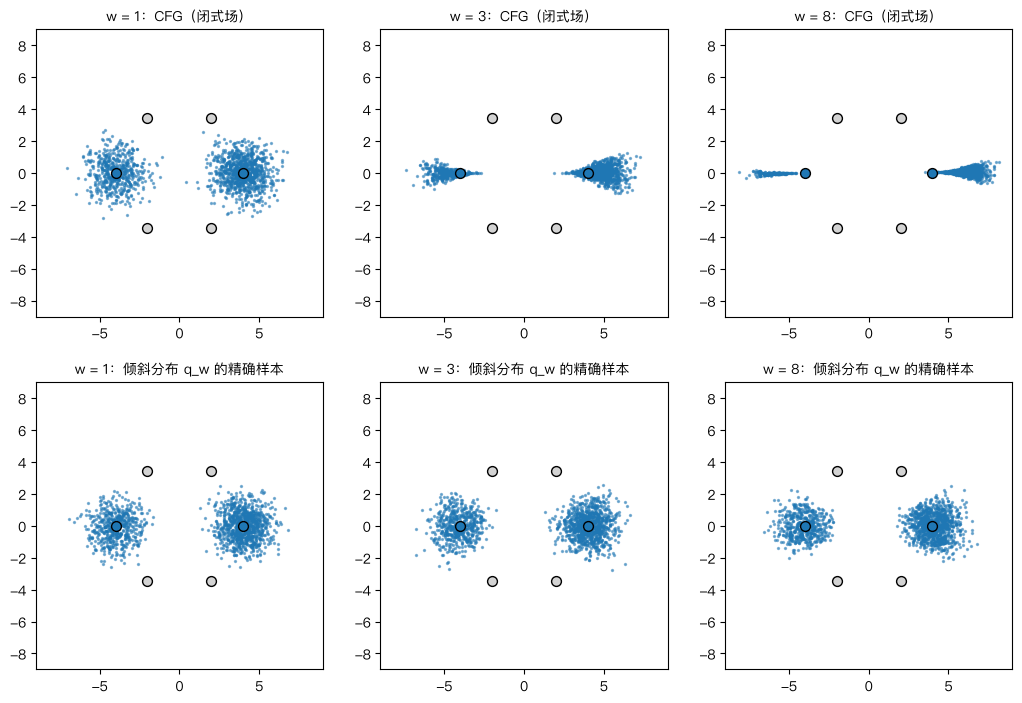
CFG 不是在 里采样,而且差得很远。 几乎不随 变化:,而类别 0 的大部分质量所在之处 本来就接近 1,倾斜只削掉了类别之间重叠的那一小片。CFG 却把每个峰压成沿径向的一根细条,推出去很远,还改变了类内比例。CFG 比”倾斜”激进得多。
一维的例子更干净(第 3 部分):,,各占一半,对 做 CFG(4 万个粒子); 的均值和标准差在细网格上数值积分:
| CFG 的均值 | 的均值 | CFG 的标准差 | 的标准差 | |
|---|---|---|---|---|
| 1 | −1.501 | −1.500 | 0.995 | 1.000 |
| 2 | −2.149 | −1.664 | 0.719 | 0.889 |
| 3 | −2.553 | −1.738 | 0.628 | 0.848 |
| 5 | −3.136 | −1.824 | 0.548 | 0.807 |
时两者的均值之差(1.3)比 的标准差还大。
为什么? CFG 在每个时刻 用的是 的得分。但”先倾斜、再加噪”和”先加噪、再倾斜”不是一回事:对 沿高斯路径加噪,得到的分布族不等于每个时刻的 各自倾斜。CFG 沿着一族”每一刻都是倾斜分布”的快照走,而这族快照并不是任何一条概率路径——它们之间不满足连续性方程,终点也就不是 。原课讲义说 CFG 是一个启发式,正是这个意思。Bradley & Nakkiran(2024)、Chidambaram et al.(2024)等工作从理论上分析了 CFG 到底采样什么,结论都是”不是 “,而且 CFG 倾向于把样本推向分布支撑的”边缘”——和本节的实验一致。
3.3 训练 CFG:丢弃标签的概率
03 号脚本按 Algorithm 5 训练四个条件 MLP(4×128,5000 步),只改变 ,和闭式的场比较:
| 条件场相对误差 | 无条件场相对误差 | vs | vs 闭式 CFG | :半径 | :类内比例 | |
|---|---|---|---|---|---|---|
| 0 | 0.33% | 11.4% | 0.0017 | 1.843 | 7.51 | 0.72 |
| 0.1 | 0.36% | 0.45% | 0.0023 | 0.0588 | 4.89 | 0.73 |
| 0.3 | 0.38% | 0.41% | 0.0035 | 0.0430 | 4.78 | 0.72 |
| 0.5 | 0.41% | 0.41% | 0.0039 | 0.0525 | 4.76 | 0.72 |
(闭式 CFG :半径 4.81、类内比例 0.74;两批闭式 CFG 样本之间的能量距离 −0.0016。)
- 必须丢弃标签: 时网络从没见过 ,它对 的输出只是”碰巧”的(无条件场误差 11%),CFG 完全走样:样本被推到半径 7.5 的地方。
- 丢弃概率不敏感:0.1、0.3、0.5 差别不大。条件场的误差随丢弃概率略增(条件样本少了),无条件场略减。原课 Lab 和很多论文取 0.1–0.2:无条件场只是”参照”,不需要很多样本。
- CFG 放大网络的误差: 时网络的样本和 只差 0.002–0.004, 时和闭式 CFG 却差 0.04–0.06。CFG 场的误差是 ;如果两个误差彼此独立, 时标准差放大约 倍。CFG 的样本又挤在很窄的区域里,位置上的小偏差在能量距离里很显眼。不过半径、类内比例这些宏观性质都学对了。
📌 代码 02、03:
python3 02_cfg.py(约 4 秒);python3 03_train_cfg.py(约 35 秒;--quick是冒烟测试)。
4. 图像上的 CFG · CFG on images
4.1 像素数字
原课 Lab 3 在 MNIST 上训练带 CFG 的流模型。本讲义不下载数据,改用代码画出来的 12×12”像素数字”(pixel_digits.py):按七段数码管的笔画画出 0–9,每张图的大小、位置、倾斜、笔画粗细都随机;另外每一段有 4% 的概率被画错(该有的没画、不该有的画了),模拟潦草的手写——约 25% 的图至少错一段,其中一部分本身就说不清是哪个数字。
评估用一个在真实数字上训练的小分类器(在新图上准确率 89.3%,上限受”画错”限制):
- 分类器判对的比例:提示遵循度;
- 风格多样性:同一个数字的”墨水量、重心横坐标、重心纵坐标”的标准差,除以真实图像的(1 = 一样多样);
- Fréchet 距离:在分类器的 64 维特征上,生成图像与真实图像的 Fréchet 距离(FID 的玩具版,Heusel et al. 2017);
- 过饱和像素:像素 的比例(真实像素都在 内)。
4.2 结果
04 号脚本训练一个条件 MLP(144 + 1 + 11 → 512 → 512 → 512 → 144,约 68 万参数,3000 步、批大小 256,,约 18 秒),每个 生成 1000 张(欧拉 50 步,同一批初始噪声):
| 引导强度 | 分类器判对 | 平均置信度 | 风格多样性 | Fréchet 距离 | 过饱和像素 |
|---|---|---|---|---|---|
| (无条件) | 10.3% | 0.104 | 0.96 | 14.56 | 4.9% |
| (条件) | 90.2% | 0.780 | 0.78 | 2.44 | 4.9% |
| 97.9% | 0.908 | 0.73 | 4.37 | 6.0% | |
| 99.2% | 0.952 | 0.70 | 13.26 | 7.5% | |
| 99.9% | 0.979 | 0.67 | 40.86 | 11.1% | |
| 100% | 0.990 | 0.64 | 108.40 | 17.3% | |
| 真实图像 | 89.4% | 0.838 | 1.08 | 0.35(两批真实之间) | 0.0% |
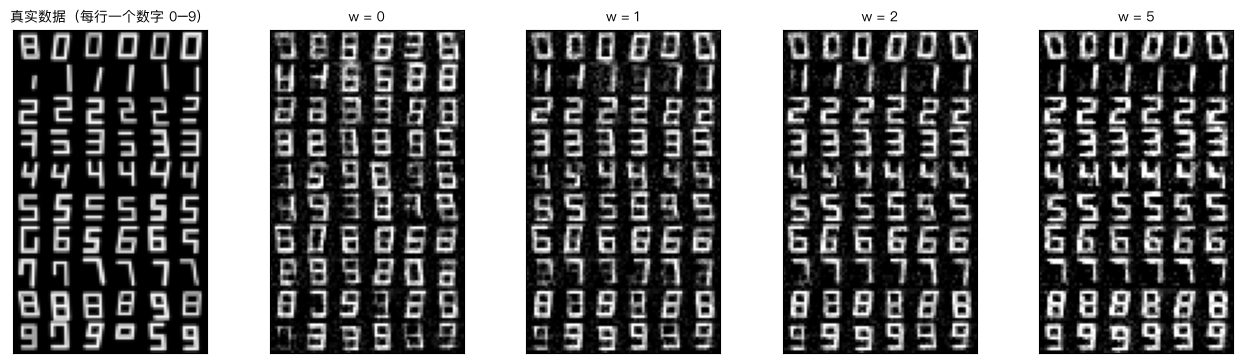
(每张小图里一行是一个数字 0–9。:无条件生成,数字之间的”混合体”;:大多可辨认,但有些模糊、有些画错;:干净整齐;:对比度过高,背景出现亮斑。)
和二维实验完全一致:
- 忠实地复现了数据:判对的比例和真实数据差不多(90.2% vs 89.4%),Fréchet 距离最小。“有一成图像说不清是哪个数字”是数据分布的一部分,条件模型把它也学来了。
- 增大,提示遵循度超过真实数据(99–100%),代价是风格多样性下降(大小、位置、粗细越来越统一)、离真实分布越来越远(Fréchet 距离从 2.4 涨到 108)、过饱和越来越严重。
- 训练 3000 步的小网络本身就比真实数据单调一些( 时风格多样性 0.78 而不是 1):学到的分布偏向”典型”的样本,CFG 在此基础上进一步牺牲多样性。
一个依赖于数据的结论。写这一节时,第一版数据没有”画错”的笔画。那时条件模型()的判对率已经是 99.9%,CFG 在提示遵循度上毫无用处,只让 Fréchet 距离变差(:12.3、26.0、109;练习 6)。CFG 的价值在于数据里的提示本身就有噪声、条件信号偏弱的时候——真实的图文数据正是这样。
4.3 实践中的
是”提示遵循度 vs 多样性 / 真实感”的旋钮。实践中常用几倍的量级(文生图模型一般在 3–8 之间),按应用调。围绕它有不少改进,这里只点名:
- 负面提示(negative prompt):把 换成 ,既推向 、又推离 (练习 5)。
- 过饱和的处理:Imagen(Saharia et al. 2022)的”动态阈值”在每一步把预测的干净图像裁剪回合理范围,缓解大 下的过饱和。
- 只在一段时间里引导:Kynkäänniemi et al.(2024)发现只在中间的一段噪声水平上用 CFG,能在保持遵循度的同时减少多样性损失。本讲的二维例子里,引导的效果几乎全部来自前半段(练习 4)。
📌 代码 04:
python3 04_pixel_digits_cfg.py(约 25 秒;--quick是冒烟测试)。
5. 全景 · The big picture
引导在今天的大模型里无处不在。原课 slides 的说法是:几乎所有生成的图像和视频都用了 CFG。Stable Diffusion 3、Meta Movie Gen 等模型的训练都按 Algorithm 5 随机丢弃提示(文本嵌入被替换成”空文本”的嵌入),采样时用 CFG。
| 方法 | 需要什么 | 场 | 代价 |
|---|---|---|---|
| vanilla guidance | 条件网络 | 提示遵循度受数据限制 | |
| 分类器引导 | 无条件网络 + 含噪分类器 | 另训分类器;梯度可能”对抗” | |
| 无分类器引导 | 一个带 的条件网络 | 每步两次前向;多样性下降;放大误差 |
本讲的提示是 3 个或 10 个类别,用独热编码喂给网络。真实的提示是一段文字:先用文本编码器(CLIP、T5 等)变成一串向量,再通过交叉注意力等方式注入网络。网络还要处理几百万维的图像。这些是第 5 讲的内容。
6. 小结 · Summary
- 条件生成:对 对做条件流匹配,网络以 为额外输入,学到引导向量场 ,采样得到 (vanilla guidance)。 本身就包含不太像 的样本,提示遵循度往往不够。
- 贝叶斯公式:,换成向量场 。
- 分类器引导:把分类器项放大 倍。提示遵循度迅速饱和,样本被推向”最不像别的类”的地方,类内比例被扭曲。分类器必须在带噪数据上训练。
- 无分类器引导:,所以 。一个网络、训练时以概率 丢弃标签(Algorithm 5);不依赖于参数化。
- CFG 是启发式:它不采样倾斜分布 ,而且比 激进得多;它会放大网络的误差。
- 图像上: 增大,提示遵循度超过真实数据,多样性下降、离真实分布越来越远、过饱和;CFG 的价值在于数据里条件信号偏弱的时候。
7. 常见误区 · Common pitfalls
- “条件生成模型学到的是 。” 是数据点, 是提示,两者完全不同。 有公式、不用学;网络学的是对 平均后的 (§1.2)。
- ” 就是 CFG 的默认值。” 是不引导的条件生成;引导要 。(有的代码库把 定义为 ,也有的定义为 ,后者的 才是不引导,读代码时要看清楚。)
- “CFG 采样的是 。” 不是,而且差得很远(§3.2)。
- “训练 CFG 要两个网络。” 一个网络,训练时随机丢弃标签(§3.1)。
- “不丢弃标签也能做 CFG。” 网络从没见过 ,无条件场是错的,CFG 完全走样(§3.3)。
- “现成的图像分类器可以拿来做分类器引导。” 必须是在所有噪声水平上训练的含噪分类器(§2.3)。
- ” 越大越好。” 遵循度很快饱和,之后只剩多样性下降和过饱和(§4.2)。
- “CFG 的效果在每个时刻都一样重要。” 至少在本讲的例子里,效果几乎全部来自噪声较大的前半段(练习 4)。
8. 练习 · Exercises
练习 1(分类器引导的得分)。证明分类器引导 对应的”得分”是 ,并说明 时为什么回到 。
参考答案
由换算公式,向量场 对应得分 。,所以对应的得分是 。 时由贝叶斯公式 ,常数 不影响梯度。
练习 2(CFG 不依赖于参数化)。设网络预测噪声 ,换算 (第 3 讲 §2)。证明对 做 CFG 与对 做 CFG 得到同一个向量场。
参考答案
,正是用 换算出的速度。关键是 , 那一项没有被放大。
练习 3(高斯的例子:CFG vs 倾斜分布)。设 、(一维),CondOT 路径。(a) 求 的均值和方差。(b) CFG 的场对 是线性的,所以终点仍是高斯;证明 CFG 终点的方差是 ,并数值求出 时的均值。
参考答案((b) 的均值来自作者的数值积分)
(a) 精度相加:,方差 0.4;均值 。 (b) 对数据 ,CondOT 的边缘场是 ,,。CFG 场的 系数是 ,方差满足 ,积分得 ,,所以 : 时是 0.0625,远小于 的 0.4。数值积分(20 万步)给出 时均值 1.50( 是 1.2)。CFG 把方差按”几何平均”组合(),倾斜分布按”精度相加”组合,两者在 时不同。
练习 4(编程:只在一段时间里引导)。在 02_cfg.py 里,让 CFG()只在 内生效,其余时间用条件场 。比较 、、、。
参考答案(作者机器上的结果,类别 0,欧拉 200 步)
| 引导区间 | 平均半径 | 类内比例 | 峰内散度 | 与 的能量距离 | |
|---|---|---|---|---|---|
| (全程) | 100% | 4.80 | 0.75 | 0.90 | 0.531 |
| 99.9% | 4.79 | 0.75 | 0.90 | 0.528 | |
| 91.1% | 4.11 | 0.63 | 0.88 | 0.001 | |
| 100% | 4.51 | 0.65 | 0.75 | 0.125 |
CFG 的效果几乎全部来自前半段(噪声大、“决定去哪个峰”的阶段):只在前半段引导和全程引导几乎一样;只在后半段引导,分布几乎不变(能量距离 0.001),但”非常确定”的比例从 77% 升到 91%——它只是把样本往峰的”安全”一侧挪了一点。中间一段的折中:遵循度 100%,类内比例几乎没被扭曲(0.65)。这和 Kynkäänniemi et al.(2024)“在高噪声段关掉引导可以保住多样性”的发现方向一致。
练习 5(思考:负面提示)。把 CFG 里的 换成 。用贝叶斯公式解释这个场在做什么。
参考答案
,差项 。它推动样本去”更像 、更不像 “的地方:一个” 对 “的对比分类器的梯度。
练习 6(编程:没有画错的数字)。把 pixel_digits.make_digits 的默认 flip 改成 0,重新运行 04_pixel_digits_cfg.py。CFG 还有用吗?
参考答案(作者机器上的结果)
分类器在新图上的准确率 100%。 时:分类器判对 9.9%、99.9%、100%、100%;Fréchet 距离 51.2、12.3、26.0、109.0;风格多样性 1.265、0.870、0.803、0.765。 已经几乎全对,CFG 在提示遵循度上没有好处,只让生成的分布离真实数据更远、更单调。数据里的条件信号很强时,CFG 是多余的。
9. 延伸阅读 · Further reading
- 原课讲义第 5 章和 Lab 3(https://github.com/eje24/iap-diffusion-labs ,2026 分支)。
- Dhariwal & Nichol, Diffusion Models Beat GANs on Image Synthesis(NeurIPS 2021):分类器引导、含噪分类器。
- Ho & Salimans, Classifier-Free Diffusion Guidance(NeurIPS 2021 Workshop;arXiv:2207.12598)。
- Bradley & Nakkiran, Classifier-Free Guidance is a Predictor-Corrector(2024);Chidambaram et al., What does guidance do? A fine-grained analysis in a simple setting(NeurIPS 2024):CFG 到底采样什么。
- Kynkäänniemi et al., Applying Guidance in a Limited Interval Improves Sample and Distribution Quality in Diffusion Models(NeurIPS 2024)。
- Saharia et al., Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding(Imagen,NeurIPS 2022):大 与动态阈值。
- Heusel et al., GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium(NeurIPS 2017):FID。
10. 下一讲预告 · Next lecture
本讲的网络是一个吃”展平的像素 + 时间 + 独热标签”的 MLP,图像只有 12×12。真实的模型要处理 1024×1024 的彩色图像、一段任意长的文字。第 5 讲要回答:
- 时间 和提示 怎样喂给网络?(傅里叶时间嵌入、文本编码器、adaLN、交叉注意力)
- 网络长什么样?(U-Net 与 Diffusion Transformer)
- 为什么几乎所有大模型都不在像素空间、而在一个 VAE 的潜空间里生成?潜空间要满足什么条件才”好学”?
- Stable Diffusion 3、Meta Movie Gen 是怎样把前四讲的东西组装起来的?