对应 Maps to:MIT 6.S184 2025 年 Lecture 6 客座讲座(Jason Yim,MIT;slides 公开)。 阅读材料:Chen & Lipman (2024) Flow Matching on General Geometries(黎曼流匹配);Yim et al. (2023) SE(3) Diffusion Model with Application to Protein Backbone Generation(FrameDiff);Yim et al. (2023) Fast Protein Backbone Generation with SE(3) Flow Matching(FrameFlow);Bose et al. (2024) SE(3)-Stochastic Flow Matching for Protein Backbone Generation(FoldFlow);Campbell et al. (2024) Generative Flows on Discrete State-Spaces(MultiFlow);De Bortoli et al. (2022) Riemannian Score-Based Generative Modelling。 依据说明:客座讲座的 slides 已公开(见 2025 年课程主页),本讲依据上述论文写成。只讲生成建模的数学与公开的方法论:数据为什么住在流形上、圆周和旋转群的几何、黎曼流匹配、链状结构的坐标选择;不涉及任何具体的生物功能设计。代码全部是通用的几何玩具(圆周上的角度、三维旋转、二维的”链”),没有任何生物数据。几处结果与我原先的预期不一致(§2.3 朴素方法在多步时并不差;§4.3 欧氏基线失败的方式),如实报告。 配套代码 Code:
code/lecture09/(4 个脚本 + 1 个模块;PyTorch + matplotlib;每个脚本 2–16 秒,都完整运行过) 预计阅读时间:4 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清哪些数据”住在”弯曲的空间里(角度、旋转、刚体框架),以及”把坐标当欧氏空间”会出什么问题。
- 在圆周 上做流匹配:测地线插值、常数的条件速度、用 作为网络输入、每步折返的采样。
- 掌握旋转群 的基本几何:切空间与 、hat / vee、指数映射(Rodrigues 公式)与对数映射、测地距离、均匀分布、测地线插值。
- 写出黎曼流匹配的一般配方,并在 上实现:条件路径 ,体坐标系下的常数角速度。
- 理解链状结构的坐标选择:笛卡尔坐标 vs 内坐标的权衡,刚体框架 的折中;知道平移 / 旋转不变性怎样处理。
- 读懂 FrameDiff、FoldFlow、MultiFlow 这类方法在数学上做了什么。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 条件路径、条件向量场、边缘化技巧、连续性方程 | 第 2 讲 §2–§3 |
| 少步采样与轨迹的弯曲 | 第 7 讲 §1 |
| 生成器匹配(ODE、跳跃的组合) | 第 6 讲 §6 |
| 矩阵指数、奇异值分解 | 线性代数;前置讲 P1 |
本讲不讲一般的黎曼几何(联络、曲率等),只用到”切空间、测地线、指数 / 对数映射”这几个概念,并且只在圆周和 这两个具体的例子上用。
0.3 本讲地图 Map
§1  为什么数据住在流形上;"坐标会骗人"
§2  圆周 S¹ 上的流匹配:测地线 vs 把角度当实数                ← 代码 01
§3  旋转群 SO(3) 的几何:指数 / 对数映射、均匀分布、插值        ← 代码 02
§4  黎曼流匹配:一般配方与 SO(3) 上的实现                       ← 代码 03
§5  链与刚体框架:坐标的选择、SE(3)、不变性;蛋白质骨架生成的方法论  ← 代码 04
§6  小结   §7  常见误区   §8  练习   §9  延伸阅读   §10 全课结语
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 流形(数据住的空间); 是 处的切空间(“在 处能往哪些方向走”) | |
| 把角度折返到 | |
| , | ↔ 反对称矩阵: |
| , | 的指数映射(旋转向量 → 旋转矩阵)和对数映射(反过来) |
| 测地距离: 的转角, | |
| 刚体变换(旋转 + 平移);一个”刚体框架” |
1. 为什么数据住在流形上 · Why manifolds
1.1 几个例子
前八讲的数据都在 里(或离散空间里)。但很多数据天然不是:
- 角度:机器人关节的转角、分子里化学键的扭转角(二面角)、风向。角度绕一圈回到原处: 和 是同一个点。它住在圆周 上。
- 三维旋转:相机的朝向、刚体的姿态。旋转不能”加一半”:两个旋转矩阵的平均一般不是旋转矩阵。它住在旋转群 上(一个三维的弯曲空间)。
- 刚体框架:一个刚体的位置 + 朝向,。蛋白质骨架的常见表示是”每个残基一个刚体框架”(§5.3)。
1.2 坐标会骗人
我们总可以给这些空间选一组坐标(角度 、欧拉角、四元数、旋转矩阵的 9 个元素),然后”假装”它是欧氏空间。问题是坐标会撒谎:
- 切口:角度坐标在 处切开了圆周, 和 在坐标里相距 6,在圆周上只相距 0.28。
- 奇点:欧拉角在俯仰角 处”万向节死锁”,两个角度合并成一个自由度。
- 多余的维度:旋转矩阵有 9 个数,只有 3 个自由度;在 里直线插值,中间点不是旋转矩阵(§3.3)。
- 重复:四元数 和 表示同一个旋转。
- “均匀”不均匀:欧拉角各自均匀,得到的不是旋转的均匀分布(§3.2)。
流匹配的条件路径、条件速度、先验分布,全都依赖”空间长什么样”。本讲的思路是:用空间本身的几何(测地线、切空间、指数映射)来定义它们,而不是借用某一组坐标。
2. 圆周上的流匹配 · Flow matching on the circle
2.1 测地线流匹配
圆周上从 到 的测地线是较短的那段弧。把第 2 讲的 CondOT 翻译过来:
条件速度是常数(沿较短的弧匀速走),和 CondOT 的 完全对应。三处实现细节:
- 先验:圆周上的均匀分布(圆周是紧的,均匀分布存在; 上没有,所以那里用高斯)。
- 网络输入:,而不是 本身——这样 两侧对网络来说是同一个地方,网络的输出自动是圆周上的连续函数。
- 采样:欧拉一步后折返,。
对照的”朴素”版本:把 当实数,,目标 ,网络输入 ,采样时在实数轴上积分、最后才折返。
2.2 实验:路径长度
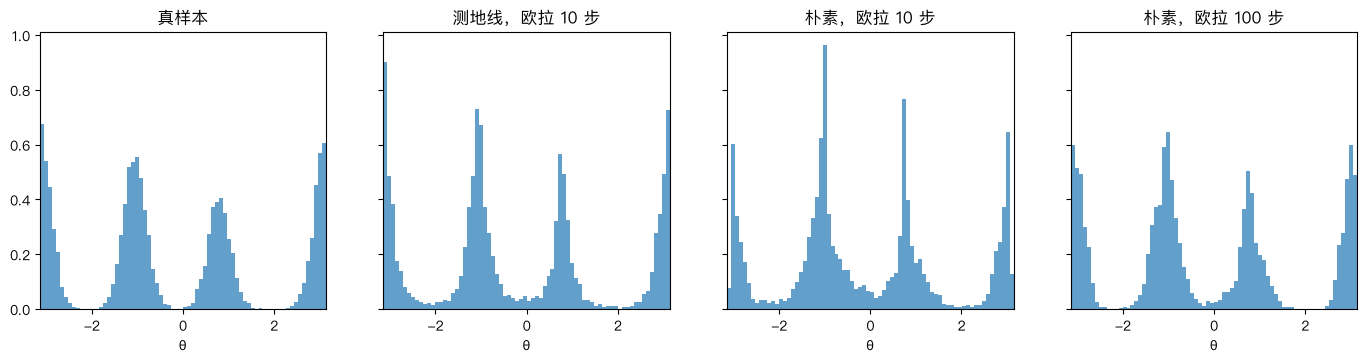
01 号脚本的数据是三个包裹高斯(标准差 0.25),中心在 、、,权重 0.4 / 0.35 / 0.25。第一个峰正好在切口上。
| 插值方式 | 平均路径长度 | 最长 | “绕远路”(长度 > π)的比例 |
|---|---|---|---|
| 朴素(实数轴上的直线) | 2.213 | 6.274 | 27.7% |
| 测地线(圆周上较短的弧) | 1.565 | 3.142 | 0% |
那个峰的数据点里,47.1% 的朴素路径要绕远路——从 到 ,朴素路径横穿整个圆,经过另外两个峰。
2.3 实验:朴素方法并不总是差
两个模型各训练 6000 步(4 层 × 128 的 MLP),欧拉 100 步采样 8000 个:
| 模型 | 能量距离 | 三个峰的比例 | TV | 峰内散度 |
|---|---|---|---|---|
| 真样本(噪声地板) | −0.0001 | 0.399 / 0.351 / 0.250 | 0.001 | 0.998 |
| 测地线流匹配 | −0.0001 | 0.403 / 0.357 / 0.240 | 0.010 | 1.058 |
| 朴素流匹配 | 0.0002 | 0.391 / 0.362 / 0.247 | 0.012 | 1.067 |
积分 100 步时两个模型一样好。我原以为朴素模型会在切口上的峰里留下一道”缝”,实际没有:实数轴上的分布(切口两侧各半个峰)也是一个完全合法的分布,流匹配照样能学,最后折返回圆周就对了。
差别在少步(能量距离 / TV / 峰之间):
| 欧拉步数 | 测地线 | 朴素 |
|---|---|---|
| 1 | 0.0684 / 0.090 / 2.6% | 1.2243 / 0.448 / 0.0% |
| 2 | 0.0308 / 0.031 / 5.6% | 0.3620 / 0.382 / 2.3% |
| 5 | 0.0039 / 0.012 / 1.1% | 0.1124 / 0.206 / 2.4% |
| 10 | 0.0007 / 0.009 / 0.5% | 0.0225 / 0.088 / 0.5% |
| 100 | −0.0001 / 0.010 / 0.1% | 0.0002 / 0.012 / 0.0% |
朴素的条件路径又长、又互相交叉(绕远路的路径横穿其他峰),边缘轨迹因此很弯,少步采样就差——这是第 7 讲的教训在流形上的翻版。还有一个原则问题:朴素模型依赖于”在哪里切开圆周”这个任意的选择(练习 3 换一个切口),测地线模型只依赖圆周本身。
3. 旋转群 SO(3) 的几何 · The geometry of SO(3)
3.1 切空间、指数映射与对数映射
。
- 切空间:在 处,所有可能的速度 都形如 ,(“体坐标系”下的角速度)。证明:对 求导得 ,即 是反对称矩阵。所以 是三维的,速度用 3 个数描述。
- 指数映射:从单位矩阵出发、以恒定角速度 转 1 秒,到达 ——绕轴 转角 。Rodrigues 公式:
- 对数映射:反过来,给定 求旋转向量 :,。 时 ,要改用对称部分求转轴(代码
manifold_lib.so3_log)。 - 测地距离: 的转角 。
02 号脚本第 1 部分:2 万个随机旋转上 与 的最大差 ;转角接近 时升到 —— 在 附近是平的,从迹反推转角丢掉了一半的有效数字。
3.2 均匀分布
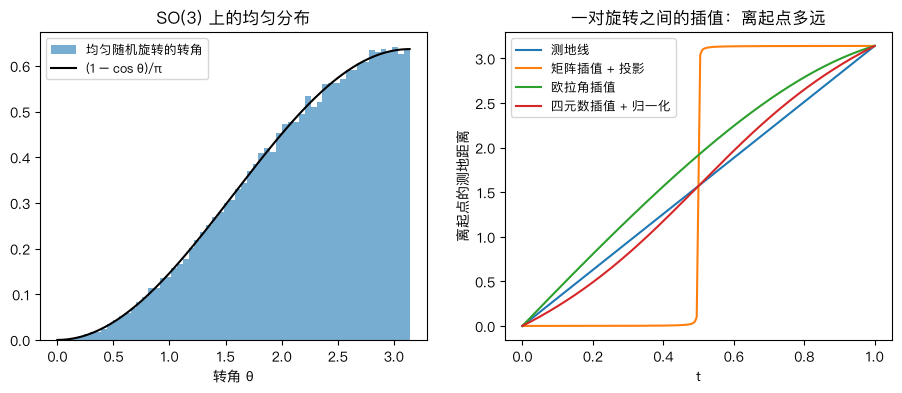
是紧的,有一个”均匀分布”(Haar 测度):把 4 维标准高斯归一化成单位四元数,再转成旋转矩阵。它的转角不是均匀的,密度是 (练习 2)——集中在 附近:随机一个旋转,大概率”转了很多”。
02 号脚本第 2 部分:10 万个均匀随机旋转的转角直方图和 逐格吻合,平均转角 2.2073(理论 )。对照:三个欧拉角各自均匀得到的旋转,中等转角(1.6–2.4 附近)的多了,小转角和接近 的都少了;平均转角碰巧差不多(2.2008),只看平均会被骗。“在坐标里均匀”≠“在流形上均匀”——先验分布选错了,生成模型从一开始就是错的。
3.3 两个旋转之间怎样”走直线”
02 号脚本第 3 部分比较五种插值(2000 对随机旋转,每条路径 200 个点):
| 插值方式 | 在 SO(3) 上? | 路径长度 / 测地距离(中位数 / 最大) | 最快 / 最慢速度(中位数 / 最大) |
|---|---|---|---|
| 测地线 | 是 | 1.000 / 1.000 | 1.00 / 1.0 |
| 矩阵直线插值(不投影) | 否( 达 1.41, 可到 0) | — | — |
| 矩阵直线插值 + 投影回 SO(3) | 是 | 1.000 / 1.000 | 5.88 / 145297 |
| 欧拉角直线插值 | 是 | 1.065 / 3.527 | 1.16 / 2.7 |
| 四元数直线插值 + 归一化 | 是 | 1.000 / 1.000 | 1.41 / 2.0 |
只有测地线同时满足:在流形上、路径最短、速度均匀。矩阵直线插值在 处,最小奇异值的中位数只有 0.410(旋转矩阵的奇异值都是 1),转角接近 的一对,中点几乎是奇异矩阵。欧拉角插值的路径最长可以是测地距离的 3.5 倍,而且依赖于欧拉角的约定。
测地线的速度(第 4 部分): 是反对称矩阵(数值误差 量级),并且 是常数——沿测地线以恒定的体角速度转动。这正是下一节流匹配的回归目标。
4. 黎曼流匹配 · Riemannian flow matching
4.1 一般配方
Chen & Lipman(2024)把流匹配推广到黎曼流形,第 2 讲的四步几乎一字不改:
- 先验 :流形上的一个简单分布(紧流形上用均匀分布)。
- 条件路径:从 沿测地线走到数据点 :。
- 条件速度:,它在切空间里。
- 损失:,用流形的度量 量长度。
边缘化技巧照样成立(连续性方程在流形上也成立),所以回归条件速度就学到了边缘速度。采样时沿切向量走一小步,再用指数映射回到流形上:——“测地线欧拉法”,样本永远不会离开流形。
没有闭式测地线的流形(例如一般的网格曲面),Chen & Lipman 用”谱距离”构造条件路径,不需要测地线。圆周、球面、、环面都有闭式的测地线,直接用即可。
4.2 在 SO(3) 上
代入 的几何(§3):
网络 输入旋转矩阵的 9 个数和 ,输出 3 维角速度;损失 ;采样 。这就是 FoldFlow、FrameFlow 里旋转部分的做法。
和扩散的对比。FrameDiff(Yim et al. 2023)用的是 上的扩散:前向过程是 上的布朗运动,它的转移密度(“各向同性高斯” IGSO(3))要用一个无穷级数计算,得分函数也要从这个级数里求。流匹配只需要测地线和指数 / 对数映射,简单得多——这也是第 2 讲”流匹配比扩散更容易推广”的一个具体例子。
4.3 实验
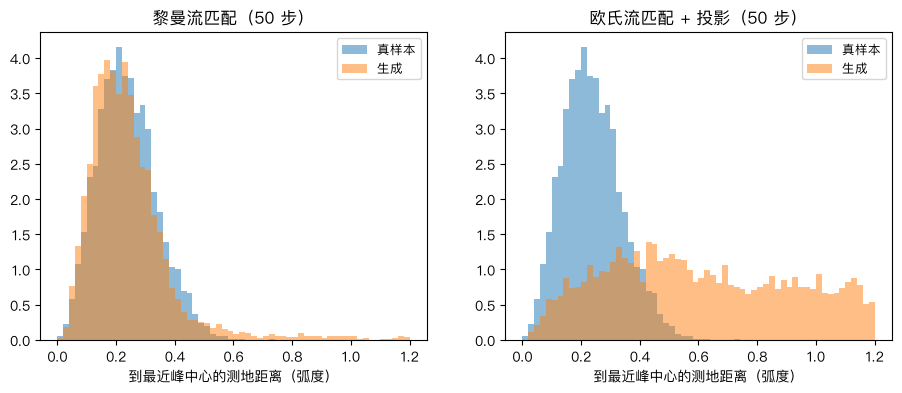
03 号脚本:数据是 上三个集中的峰(尺度 弧度,中心两两相距 2.00、2.00、2.55 弧度,权重 0.5 / 0.3 / 0.2),先验是 上的均匀分布。对照:把旋转矩阵当 9 维向量做欧氏流匹配,最后用 SVD 投影回最近的旋转矩阵。
| 模型 | 欧拉步数 | 三个峰的比例 | TV | 峰内散度 | 峰之间 |
|---|---|---|---|---|---|
| 真样本 | — | 0.509 / 0.297 / 0.194 | 0.009 | 0.99 | 0.0% |
| 黎曼流匹配 | 5 | 0.524 / 0.272 / 0.204 | 0.028 | 1.66 | 4.0% |
| 黎曼流匹配 | 10 | 0.517 / 0.278 / 0.205 | 0.022 | 1.35 | 1.9% |
| 黎曼流匹配 | 50 | 0.514 / 0.282 / 0.203 | 0.018 | 1.15 | 0.7% |
| 欧氏 + 投影 | 5 | 0.649 / 0.217 / 0.133 | 0.149 | 2.88 | 17.2% |
| 欧氏 + 投影 | 50 | 0.605 / 0.238 / 0.158 | 0.105 | 2.80 | 16.4% |
(峰内散度 = 到最近峰的均方根测地距离 / ,理想值约 1;“峰之间” = 离所有峰都超过 弧度。)
- 黎曼流匹配的样本始终在 上(),步数越多越好;50 步时到最近峰中心的中位距离 0.218(真样本约 0.23)。
- 欧氏流匹配差得多:样本太散(峰内散度 2.8,16% 落在峰之间),权重偏向第一个峰。积分出来的 3×3 矩阵大多接近旋转矩阵(奇异值中位数 1.007),但一部分离得很远(最小奇异值 0.046),投影把它们送到不确定的地方。
- 欧氏版本几乎不随步数改善(5 → 50 步:17.2% → 16.4%)。我原以为它的问题是”投影前离流形太远”,加步数能缓解;实际上它的误差不是积分误差,而是”在错误的空间里建模”: 里的直线插值经过奇异值很小的矩阵(§3.3),网络要学一个 9 维空间里的场,而数据和噪声都只住在其中一个 3 维的曲面上。
5. 链与刚体框架 · Chains and rigid frames
5.1 一条链该用什么坐标
很多结构数据是”链”:相邻两个单元之间的距离基本固定,形状由相邻单元之间的转角决定(分子的骨架、机械臂的连杆、蛋白质的主链)。生成这样的数据,有两种自然的坐标:
- 笛卡尔坐标:直接生成每个点的位置。
- 内坐标:只生成键长、键角、扭转角(键长往往固定,只剩角度),再从头到尾”搭”出整条链。角度住在环面 上,用 §2 的测地线流匹配。
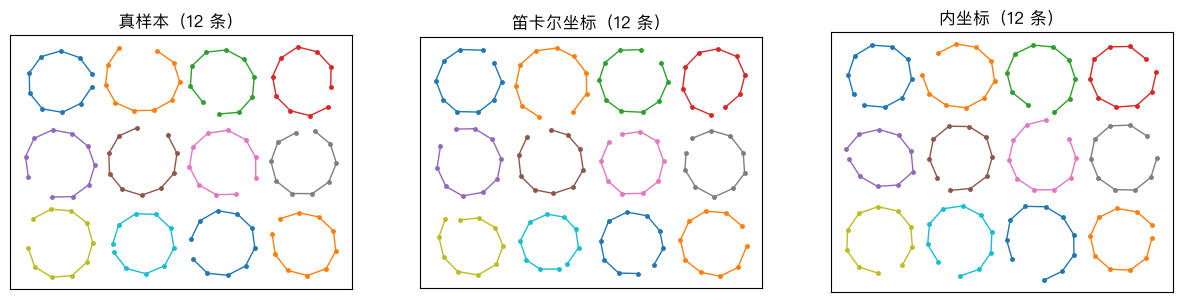
04 号脚本用一个二维玩具比较两者:10 个点、9 段长度为 1 的键,相邻两段之间转 ±36°(每条链要么全部左转、要么全部右转,加 4° 的随机扰动),整条链随机旋转并平移到质心为 0。8 个 36° 的转角加起来是 288°,链几乎闭合成一个环。
| 表示 | 键长偏差 | 转角偏差 | 全部同向转 | 首尾距离(平均) | 首尾距离分布的 W1 |
|---|---|---|---|---|---|
| 真样本 | 0.0000 | 3.19° | 100.0% | 1.036 | 0.0113(噪声地板) |
| 笛卡尔坐标(20 维) | 0.0476 | 4.36° | 100.0% | 1.006 | 0.0311 |
| 内坐标(8 个转角) | 0.0000 | 3.56° | 99.7% | 1.203 | 0.1663 |
- 局部几何:内坐标天然满足约束(键长精确为 1),转角也学得更准;笛卡尔坐标的键长平均差约 5%——网络要从 20 个数里”自己学会”键长是 1。
- 整体形状:笛卡尔坐标好得多。内坐标的平均首尾距离比真值大 16%:每个转角只偏一点点,累积起来,“几乎闭合的环”就张开了。
放大的机制(第 2 部分):内坐标里一个转角差 2°(0.035 弧度),它后面的点都绕着它转,移动的距离 ≈ 到它的距离 × 0.035。中间的转角影响最大(第 4 个转角:末端平均移动 0.081)。链越长,这个”杠杆”越大(练习 4 把链加长到 20 个点)。
5.2 刚体框架:介于两者之间
刚体框架()是一个折中:把链分成若干个刚性的单元,每个单元一个框架 ——旋转 给出单元的朝向,平移 给出它的位置。
- 单元内部的几何由框架精确决定(把一个固定的局部模板放到框架上即可),这一点像内坐标;
- 单元的位置直接生成,不需要从头搭起,误差不会沿链累积,这一点像笛卡尔坐标;
- 相邻单元之间的约束(例如它们之间的距离和角度)仍然要模型自己学。
生成 个框架,就是在乘积流形 上做流匹配:旋转部分用 §4.2 的 流匹配,平移部分用普通的欧氏流匹配,两者共用一个网络、共用时间 。
5.3 不变性
一个结构整体平移、整体旋转之后还是同一个结构,所以数据分布对全局的刚体运动是不变的。两件事要处理:
- 平移: 上没有”均匀分布”,不能把平移当作一个均匀的先验。通常的做法是把所有位置减去质心,在”质心为 0”的子空间里生成(本讲
04号脚本也是这样做的)。 - 旋转:要么让网络等变(输入整体旋转,输出的速度跟着旋转,例如 FrameDiff 用的不变点注意力 IPA、各种等变图神经网络),要么不要求等变,而是在训练时对数据做随机旋转增广。AlphaFold3 的扩散模块是后一种思路的公开例子:直接在原子的笛卡尔坐标上做扩散,网络不等变,靠数据增广学到近似的不变性——这和 §5.1 里”笛卡尔坐标整体形状好、局部几何要学”的结论一致。
5.4 蛋白质骨架生成的方法论(公开文献的结构)
把本讲的工具放到一起,公开文献中蛋白质骨架生成模型的数学结构大致是:
| 组成部分 | 做法 | 对应本讲 |
|---|---|---|
| 表示 | 每个残基一个刚体框架 | §5.2 |
| 先验 | 旋转: 上均匀;平移:质心为 0 的高斯 | §3.2、§5.3 |
| 路径 | 旋转沿测地线,平移沿直线(FrameFlow、FoldFlow),或 / 上的扩散(FrameDiff) | §4 |
| 网络 | 对全局刚体运动等变的网络(IPA 等) | §5.3 |
| 采样 | 测地线欧拉法(旋转用指数映射,平移用普通欧拉) | §4.1 |
| 离散的部分 | 若同时生成离散的类别序列,用第 6 讲的离散流匹配,和连续部分组合(MultiFlow;第 6 讲 §6 的生成器匹配) | 第 6 讲 |
这些都是通用的生成建模工具;本讲到此为止,不讨论任何具体的生物学应用。
6. 小结 · Summary
- 流形上的数据:角度()、旋转()、刚体框架()。坐标会骗人:切口、奇点、多余维度、重复、“均匀”不均匀。
- 圆周上的流匹配:测地线插值、常数条件速度 、 输入、每步折返。朴素的”角度当实数”在多步时也能学对分布,但路径长、交叉多,少步时差很多,而且依赖切口的位置。
- 的几何:切空间 = ;Rodrigues 指数映射、对数映射( 要特殊处理);均匀分布的转角密度 ;只有测地线插值同时在流形上、最短、匀速。
- 黎曼流匹配:先验在流形上,条件路径沿测地线,条件速度在切空间里,采样用指数映射。 上条件速度是常数 。把旋转矩阵当 9 维向量的欧氏流匹配即使多步也做不对。
- 链的坐标:内坐标局部精确、长程误差累积;笛卡尔坐标整体形状好、局部几何要学;刚体框架介于两者之间。平移用”减质心”处理,旋转用等变网络或数据增广处理。
7. 常见误区 · Common pitfalls
- “角度就是一个实数,直接用就行。” 多步时可能碰巧没问题(§2.3),但路径会绕远路、少步质量差、结果依赖切口位置。
- “欧拉角各自均匀就是随机旋转。” 不是(§3.2)。
- “两个旋转矩阵的加权平均还是旋转矩阵。” 一般不是;中点甚至可以接近奇异矩阵(§3.3)。
- “把旋转矩阵当 9 维向量生成,最后投影回去就行。” 本讲的实验里,这样做 16% 的样本落在峰之间,加步数也没用(§4.3)。
- “内坐标自动满足所有几何约束,所以总是更好。” 它满足局部约束,但长程误差会累积(§5.1)。
- “平移也可以用均匀先验。” 上没有均匀分布;要先减去质心(§5.3)。
8. 练习 · Exercises
练习 1(圆周上的边缘化技巧)。圆周上的连续性方程是 ( 是局部坐标)。仿照第 2 讲 §3.4,证明按后验加权平均的条件速度 生成边缘路径。在哪一步用到了”条件速度是常数”?
参考答案
条件路径 由条件速度生成:。对 积分、交换求导和积分:,括号里正是 。证明本身不需要条件速度是常数——它只需要”条件速度生成条件路径”;常数只是让条件路径(测地线)和回归目标都很简单。这里的条件路径 是”均匀分布沿测地线推过去”得到的分布。
练习 2(均匀旋转的转角密度)。单位四元数 在 上均匀分布。证明转角 的密度是 ,。
参考答案
上的均匀分布,“极角” 的密度 ( 上距北极角距离为 的”纬度球面”是半径 的二维球面,面积 )。 和 是同一个旋转,所以只看 ,即 。换元 :密度 ,在 上归一化:,所以密度是 。平均转角 。
练习 3(编程:换一个切口)。在 01 号脚本的朴素版本里,把角度表示成 (切口在 0 而不是 ),重新训练。少步的结果怎样变化?
参考答案(作者机器上的结果)
| 欧拉步数 | 1 | 5 | 10 | 100 |
|---|---|---|---|---|
| 测地线 | 0.0684 | 0.0039 | 0.0007 | −0.0001 |
| 朴素,切口在 ±π | 1.2243 | 0.1124 | 0.0225 | 0.0002 |
| 朴素,切口在 0 | 0.9326 | 0.0508 | 0.0110 | 0.0005 |
(能量距离。)切口换到 0 之后,朴素模型的少步误差减半——0 附近恰好没有数据(在 和 两个峰之间),切口不再把一个峰劈成两半。同一个方法、同一份数据,结果取决于一个任意的坐标选择;测地线模型没有这个自由度。即使切口选得好,朴素模型在少步时仍比测地线差得多。
练习 4(编程:更长的链)。在 04 号脚本里把链加长到 20 个点、转角改成 ±18°(仍然几乎闭合成一个环)。两种表示的首尾距离误差怎样变化?
参考答案(作者机器上的结果)
| 表示(20 个点) | 键长偏差 | 转角偏差 | 全部同向转 | 首尾距离(平均;真值 1.479) | 首尾距离的 W1(地板 0.026) |
|---|---|---|---|---|---|
| 笛卡尔坐标(40 维) | 0.454 | 43.52° | 0.0% | 1.538 | 0.069 |
| 内坐标(18 个转角) | 0.0000 | 4.69° | 85.8% | 3.647 | 2.176 |
链加长以后,两种表示各自的弱点都被放大了:笛卡尔坐标在同样的训练预算下局部几何彻底失败(键长平均差 0.45,转角乱了,没有一条链”全部同向转”),但首尾距离的分布仍然不错;内坐标的局部几何仍然精确,整体形状却完全错了(首尾距离 3.6 vs 1.5:18 个转角的小偏差累积,环大幅张开)。这正是实践中用刚体框架、并给网络加上”相邻单元之间”的几何损失的原因。
练习 5(思考:欧氏基线为什么失败)。均匀随机旋转 和数据点 之间的转角往往接近 (§3.2)。用 §3.3 的结果解释:为什么 里的直线插值 在 时常常接近奇异矩阵?这对网络要学的向量场意味着什么?
参考答案
设 是绕轴 转 。,括号里的矩阵在 方向的特征值是 1,在垂直平面里是 ,模长 。、 时为 0:中点是奇异矩阵。均匀先验下转角集中在 附近,所以大量条件路径会穿过”奇异矩阵附近”这片和 毫无关系的区域;网络必须在这片区域学一个场,而采样时粒子也会经过这里,投影回 时方向很不稳定。
练习 6(思考:刚体框架之间还要学什么)。用刚体框架表示一条链时,哪些几何量由表示自动保证?哪些仍然要模型学?
参考答案
自动保证:每个单元内部的几何(把固定模板放在框架上,单元内的距离和角度精确)。仍然要学:相邻单元之间的距离和相对朝向(例如连接两个单元的键长、键角),以及整体的形状。前者是”局部、相邻”的约束,网络通常学得比较好;后者是全局的,框架表示没有内坐标那样的累积误差。这就是 §5.2 说的”介于两者之间”。
9. 延伸阅读 · Further reading
- Chen & Lipman, Flow Matching on General Geometries(ICLR 2024):黎曼流匹配,测地线与谱距离两种条件路径。
- De Bortoli et al., Riemannian Score-Based Generative Modelling(NeurIPS 2022);Huang et al., Riemannian Diffusion Models(NeurIPS 2022)。
- Yim et al., SE(3) Diffusion Model with Application to Protein Backbone Generation(FrameDiff,ICML 2023);Yim et al., Fast Protein Backbone Generation with SE(3) Flow Matching(FrameFlow,2023)。
- Bose et al., SE(3)-Stochastic Flow Matching for Protein Backbone Generation(FoldFlow,ICLR 2024)。
- Campbell et al., Generative Flows on Discrete State-Spaces(MultiFlow,ICML 2024):离散 + 连续的联合流。
- Jumper et al., AlphaFold2(Nature 2021):不变点注意力(IPA)与刚体框架;Abramson et al., AlphaFold3(Nature 2024):坐标上的扩散模块。
- Jing et al., Torsional Diffusion for Molecular Conformer Generation(NeurIPS 2022):在扭转角(环面)上的扩散。
- Solà, Deray & Atchuthan, A micro Lie theory for state estimation in robotics(2018): / 的指数映射、对数映射的实用讲解。
10. 全课结语 · Closing
九讲走下来,“生成”这件事被拆成了几个反复出现的问题:
- 用什么机器把噪声变成数据:ODE(流)、SDE(扩散)、CTMC(跳跃),以及它们在流形上的版本——第 1、3、6、9 讲。生成器的语言把它们统一起来(第 6 讲 §6)。
- 训练目标从哪来:对单个数据点构造条件路径和条件速度,边缘化技巧保证回归条件量就学到了边缘量——第 2 讲,在离散空间(第 6 讲)和流形(本讲)上原样成立。
- 怎样按要求生成、怎样做大:引导(第 4 讲)、潜空间与网络架构(第 5 讲);同样的条件生成可以以图像、文字、观测为条件(第 8 讲)。
- 怎样生成得快:拉直轨迹、蒸馏、一致性、平均速度(第 7 讲)。
几乎每一讲都有”实验结果和我原先的预期不一样”的地方,都写在了讲义和代码的 README 里。玩具实验的价值不在于数字本身,而在于:当真相已知时,可以把每一个说法拿来检验。