对应 Maps to:MIT 6.S184 Generative AI with Stochastic Differential Equations(IAP 2026),Lecture 2 · 22-Jan-2026 · Flow Matching;Lab 2(Flow Matching and Score Matching)的第 1、2 部分(2.1–2.3)、3.1 和第 4 部分。 阅读材料:原课讲义 Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(2026 版,arXiv:2506.02070)第 3 章;Lecture 2 slides(20260122_Lecture_02.pdf);原始论文 Lipman et al. (2023) Flow Matching for Generative Modeling、Liu et al. (2023) Rectified Flow、Albergo & Vanden-Eijnden (2023) Stochastic Interpolants。 依据说明:本讲以原课讲义第 3 章为主线:条件与边缘概率路径、条件与边缘向量场、边缘化技巧(定理 9)、连续性方程(定理 11)、流匹配与条件流匹配损失(定理 12)、Algorithm 3,以及 slides 里的”流匹配矩阵”。原课 Lab 2 的线性路径(任意分布之间搭桥)放在 §6.1。“环形数据上的旋转场""条件轨迹与边缘轨迹的交叉""有限数据集上的精确最优解会背诵""训练损失的地板 C 与梯度噪声""调度的比较”等实验是本讲义补充的;其中调度比较的结果与常见说法不一致,§6.2 如实报告。 配套代码 Code:
code/lecture02/(6 个脚本 + 3 个模块;PyTorch + matplotlib;脚本 2–50 秒,最长的 06 号约 50 秒,都完整运行过) 预计阅读时间:5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚条件概率路径和边缘概率路径的定义与区别,会从边缘路径采样,并解释为什么”能采样、算不出密度”。
- 推导高斯条件路径 的条件向量场,并把回归目标化简成 (CondOT 时是 )。
- 陈述并证明边缘化技巧:边缘向量场 = 条件向量场按后验 加权平均,它让粒子沿着边缘概率路径走;理解连续性方程的直觉。
- 陈述并证明定理 12:条件流匹配损失与流匹配损失只差一个常数,梯度相同;知道这个常数是什么、它为什么让训练损失降不到 0、为什么条件目标的梯度噪声更大。
- 写出并实现流匹配训练算法(Algorithm 3),训练一个流模型,并用正确的方式评估它(看样本,而不是看损失)。
- 理解流匹配的推广与局限:任意分布之间的搭桥;调度的选择没有放之四海而皆准的答案;有限数据集上的精确最优解只会背诵训练集。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 流模型、ODE、欧拉法、Algorithm 1 | 第 1 讲 §2–§3 |
| 高斯的重参数化与相加、狄拉克 δ | 前置讲 P1 §2 |
| 贝叶斯公式、后验;边缘分布”采样易、密度难” | P1 §3 |
| 条件期望与均方误差分解(本讲最核心的工具) | P1 §4 |
| 散度、连续性方程的粒子视角 | P1 §5.2、§6.3 |
| 训练循环、带噪声目标的回归、广播 bug | 前置讲 P2 §1.2、§3 |
本讲只讲流模型(ODE)。得分函数、SDE 采样、去噪扩散模型是第 3 讲的内容;条件生成(按提示生成)是第 4 讲。
0.3 本讲地图 Map
§1  问题:怎样训练流模型?为什么"先设计路径、再反推向量场"
§2  概率路径:条件路径、边缘路径、高斯路径与三种调度            ← 代码 01
§3  向量场:条件向量场;边缘化技巧;连续性方程;有限数据的陷阱    ← 代码 02、03
§4  损失:流匹配 vs 条件流匹配(定理 12);常数 C;Algorithm 3   ← 代码 04
§5  实验:训练流匹配模型                                        ← 代码 05
§6  推广:任意分布搭桥;调度的选择;训练出的网络会背诵吗?      ← 代码 06
§7  全景:流匹配矩阵、文献里的名字
§8  小结   §9  常见误区   §10 练习   §11 延伸阅读   §12 下一讲预告
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 条件概率路径:以一个数据点 为条件,, | |
| 边缘概率路径: | |
| 噪声调度(noise schedule):; 是对 的导数 | |
| 条件向量场(原课讲义写作 ) | |
| 边缘向量场(原课讲义写作 ):训练的真正目标 | |
| 神经网络向量场 | |
| , | 流匹配损失、条件流匹配损失 |
| 在 上均匀分布 |
0.5 一张总图:流匹配矩阵
Lecture 2 的 slides 用一张 2×3 的”矩阵”概括整讲,建议先记住它,读完再回来看:
| 概率路径 | 向量场 | 损失函数 | |
|---|---|---|---|
| 条件(针对单个数据点 ) | :有公式 | :有公式 | :能算 |
| 边缘(对整个数据分布平均) | :只能采样 | :算不出来 | :算不出来 |
slides 的注解是:“条件” = “针对单个数据点”,“边缘” = “对数据点的分布平均”。第一行的东西都是解析公式;第二行的东西都算不出来,但第二行才是我们真正想要的。整讲的故事就是:用第一行能算的东西,学到第二行算不出的东西。
1. 问题:怎样训练流模型? · The training problem
第 1 讲造好了流模型:,沿 走到 。没训练的网络只会产生”无意义的东西”;而用第 1 讲的”理想向量场”(我们提前算出来的那个),同样的采样循环就能把噪声变成五峰数据。所以训练要回答的问题是:
怎样调整 ,使得从 出发、沿 走到 时,?
两条”直接”的路都走不通:
- 最大似然:用 P1 §6.2 的瞬时变量替换, 可以写成”沿轨迹倒着积分散度”。但每算一次似然都要模拟一遍 ODE、每一步都要算散度( 次反向传播或带噪声的 Hutchinson 估计,P2 §2.4),训练代价高得离谱。这就是”连续归一化流”的困境。
- 直接回归:如果我们知道”正确的”向量场 ,训练就是一个普通的回归问题 。但正确的向量场是什么?满足”终点是 “的向量场有无穷多个(§2.4 会看到一个例子),而且我们只有数据样本,没有 的公式。
流匹配的思路是先设计路径,再反推向量场:
- 先规定粒子在每个时刻应该服从什么分布:一条从 到 的概率路径 (§2)。
- 再找一个让粒子恰好沿着这条路径走的向量场 (§3)。这一步对单个数据点很容易,对整个数据分布则靠”边缘化技巧”。
- 最后用回归去学这个向量场,并证明:虽然 算不出来,但可以对一个能算的”条件”目标做回归,效果完全一样(§4)。
打个比方:与其直接告诉每辆车”该怎么开”,不如先规定”每个时刻路上的车流密度应该长什么样”,再反推出每个位置、每个时刻车的速度。
2. 概率路径 · Probability paths
2.1 条件概率路径:从噪声到一个数据点
先只看一个数据点 。一条条件(插值)概率路径是一族分布 ,,满足
它把初始的噪声分布逐渐”收缩”成单个数据点。原课讲义说,你可以把概率路径想成分布空间里的一条轨迹。
最重要的例子是高斯条件路径(原课讲义 Example 8,“by far the most important”):取两个连续可微、单调的函数 (噪声调度),满足 、,令
时是 , 时方差为 0、是 (P1 §2.4)。从它采样只需一行(P1 §2.1 的重参数化):
01 号脚本第 1 部分对 、CondOT 调度(、)验证:样本均值沿直线从原点移向 ,标准差从 1.0018 缩到 0.0000()。对单个数据点而言,这条路径没有任何难处。
2.2 边缘概率路径:对所有数据点平均
把数据点也变成随机的:先抽 ,再抽 。这样得到的 的分布叫边缘概率路径:
由条件路径的两个端点条件,立刻得到 、:边缘路径在噪声和数据之间插值。对高斯路径,采样就是 , 从数据集里随便挑。
原课讲义特别强调:我们能采样 (式 (12)),但算不出它的密度(式 (13) 的积分)。这正是 P1 §3.4 的”采样容易、密度难”。01 号脚本第 2 部分在五峰数据上验证了两件事(这里能写出闭式的 ,只因为 是高斯混合):
| 时刻 | 祖先采样 vs 闭式 | 到 的距离 | 到 的距离 |
|---|---|---|---|
| +0.0000 | −0.0003 | 1.7330 | |
| −0.0012 | 0.3412 | 0.9132 | |
| +0.0032 | 1.7387 | −0.0015 |
(能量距离,噪声地板约 ±0.003。)两步采样得到的分布和闭式解一致;两端分别与噪声、数据无法区分。
2.3 三种调度
调度 决定”中途路过哪些分布”。本讲比较三种:
| 调度 | 说明 | ||
|---|---|---|---|
| CondOT | 噪声与数据的直线插值;SD3、Meta Movie Gen 用它;原课讲义 Algorithm 3 的默认 | ||
| SqrtBeta | 原课 Lab 2 用的路径 | ||
| Cosine | (“方差保持”),与 DDPM 一族的路径同类 |
一个有用的量是信噪比 :数据信号的”能量”和噪声”能量”之比。01 号脚本第 3 部分:
| 0.1 | 0.3 | 0.5 | 0.7 | 0.9 | |
|---|---|---|---|---|---|
| CondOT 的 SNR | 0.012 | 0.18 | 1 | 5.4 | 81 |
| SqrtBeta 的 SNR | 0.011 | 0.13 | 0.5 | 1.6 | 8.1 |
| Cosine 的 SNR | 0.025 | 0.26 | 1 | 3.9 | 40 |
三者两端相同(0 和 ∞),中途差别很大:SqrtBeta 的噪声消失得最晚; 时 Cosine 路径上的分布离数据最近(能量距离 0.32,另两者约 0.83–0.90)。
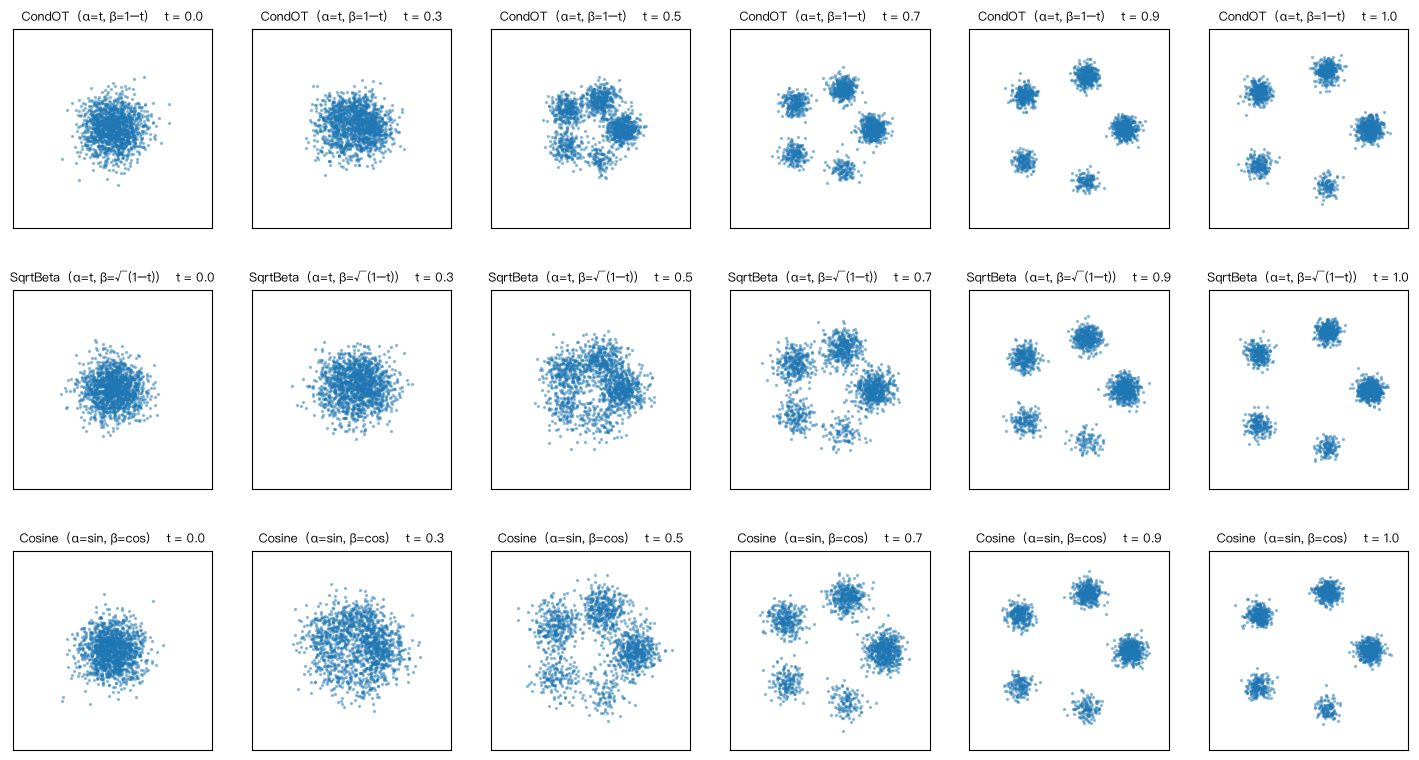
调度不改变终点( 永远是 ),只改变路径中途的样子。它会影响训练和少步采样,但影响的方向并不简单(§6.2)。
2.4 概率路径只规定”快照”
slides 有一句提醒:“概率路径只规定边缘分布(每一张快照),不规定单个粒子怎样随时间运动(没有动力学)。”
01 号脚本第 4 部分给了一个具体的例子。数据是一个环(72 个小高斯排成半径 3 的圆,几乎是旋转对称的),于是每个时刻的 也几乎是旋转对称的。设 是让粒子沿 走的边缘向量场(§3),再给它加一个旋转场 。旋转场沿着 的等高线转圈:(P1 §5.4),所以加上它不改变任何时刻的分布:
| 时刻 | 只用 :与 的能量距离 | 旋转:与 的能量距离 |
|---|---|---|
| +0.0002 | −0.0004 | |
| −0.0008 | −0.0008 |
两组粒子在每个时刻的分布都等于 ,终点都是环形数据。但同一个噪声起点的终点相差 1.995 弧度(约 114°,标准差 0.003),正好是 在单位时间里转过的角度:
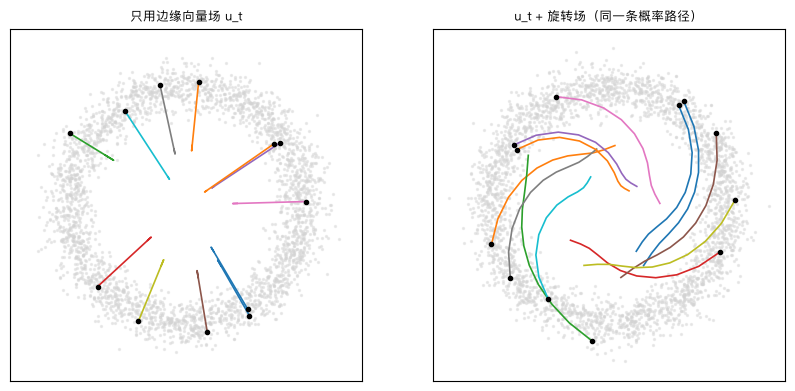
所以”选定一条概率路径”并不能唯一确定向量场。流匹配选的是一个特别的向量场:由条件向量场按后验平均得到的边缘向量场。它的轨迹是左图那样”不绕弯”的。
📌 代码 01:
python3 01_probability_paths.py。
3. 向量场 · Vector fields
3.1 条件向量场:把噪声送到一个数据点
对每个数据点 ,设 是一个条件向量场:它的 ODE 让粒子沿着条件路径走:
对高斯路径,它可以手算出来(原课讲义 Example 10)。**第一步:先写出流。**令
若 ,则 :这个流的轨迹恰好服从条件路径。**第二步:从流反推向量场。**流的定义是 ,即
把 换回来(),整理得
这就是原课讲义式 (20)。02 号脚本第 1 部分从 出发、对三种调度分别模拟这个 ODE(欧拉 1000 步),粒子在每个时刻都服从 , 时全部收缩到 。唯一的例外是 SqrtBeta 在 时还剩约 0.02 的标准差:它的 在终点发散,最后几步速度太大,1000 步的欧拉法也跟不上(离散化误差,不是公式错了)。
原课讲义说,条件向量场乍看毫无用处:它只会把所有噪声送到同一个已知的数据点 。但它是构造真正的生成向量场的积木。
回归目标的另一种写法。 把 代入上式, 的系数和 的系数分别化简为
其实这就是”固定一对 时,粒子 的速度”:对 求导即得。02 号脚本第 3 部分在 1000 组随机 上核对了两种写法(最大差 量级)。训练时用第二种写法,不用除以 ,数值上更稳定。对 CondOT,目标就是 ,与 无关。
条件轨迹的形状。 CondOT 的条件流 是从 到 的线段、匀速运动(02 号脚本第 2 部分:欧拉法 5 步就精确到舍入误差)。这就是”条件最优传输”(conditional optimal transport, CondOT)这个名字的来历。其他调度呢?
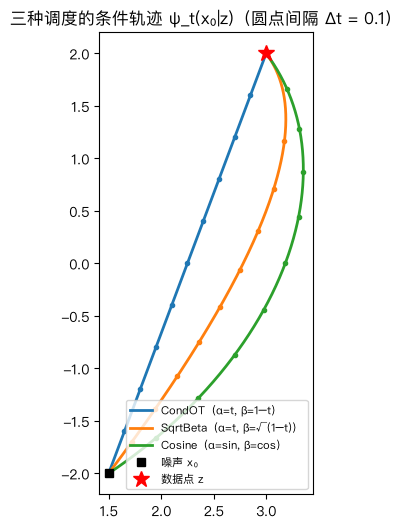
| 调度 | 路径长度 / 直线距离 | 时离直线多远 | 速度范围 |
|---|---|---|---|
| CondOT | 1.0000 | 0 | 恒为 4.27 |
| SqrtBeta | 1.0506 | 0.44 | 3.75 → 111.66 |
| Cosine | 1.1123 | 0.87 | 3.92 → 5.66 |
(,。)Cosine 和 SqrtBeta 在中途有 ,点 比线段离原点更远,轨迹向外鼓出;SqrtBeta 的速度在终点附近暴增到 CondOT 的 26 倍。注意,这些都是条件轨迹;生成时走的是边缘向量场,它的轨迹另当别论(§6.2)。
3.2 边缘化技巧:把条件向量场平均起来
现在是整讲最关键的一步。
定理 9(边缘化技巧):设 是条件向量场。定义边缘向量场 则它的 ODE 沿着边缘概率路径走:。特别地,:边缘向量场把噪声变成数据。
公式里的权重 就是贝叶斯公式(P1 §3.1)给出的后验:
所以边缘向量场可以写成一个条件期望:
原课讲义的直觉是:对每个可能的数据点 ,取”把我带到 的速度” ,再按”我相信 来自 的程度”加权平均。
第 1 讲的”理想向量场” 正是 CondOT 路径的边缘向量场。gmm_oracle.py 把它推广到任意调度:当 是高斯混合时,后验可以按成分精确算出(每个成分内用 P1 练习 3 的高斯条件化公式)。
只用数据样本也能估计它。 把式中的 换成 个样本、后验换成归一化的权重 ,就得到一个蒙特卡洛估计(自归一化重要性采样)。03 号脚本第 1 部分在 4 个点上与闭式解比较(10 次平均的误差):
| 数据样本数 | 10 | 100 | 1,000 | 10,000 | 100,000 |
|---|---|---|---|---|---|
| 1.70 | 0.21 | 0.084 | 0.026 | 0.010 | |
| 5.18 | 1.78 | 0.75 | 0.32 | 0.24 |
估计确实收敛到边缘向量场,验证了”后验加权平均”的直觉。但 越大,后验越集中在少数几个数据点上(权重”退化”),需要的样本多得多;而且这种估计要对每个查询点遍历大量数据。流匹配用回归绕开了它:网络在训练中自动完成这个”后验平均”(§4)。
条件轨迹 vs 边缘轨迹。 条件路径的定义本身就提供了一种”走法”:每个粒子配一个随机的数据点,沿条件轨迹(CondOT 时是直线)走过去。它在每个时刻的分布当然就是 。边缘向量场则用一个确定的 ODE 实现了同一条分布路径。03 号脚本第 3 部分在一维两峰数据上比较两者(2000 个粒子):
| 时刻 | 条件直线:与 的距离 | 边缘 ODE:与 的距离 |
|---|---|---|
| +0.0020 | −0.0005 | |
| +0.0039 | −0.0010 |
分布都对;但按起点排序后,终点顺序颠倒的相邻对数:条件直线 1024 对(共 1999 对),边缘 ODE 0 对。
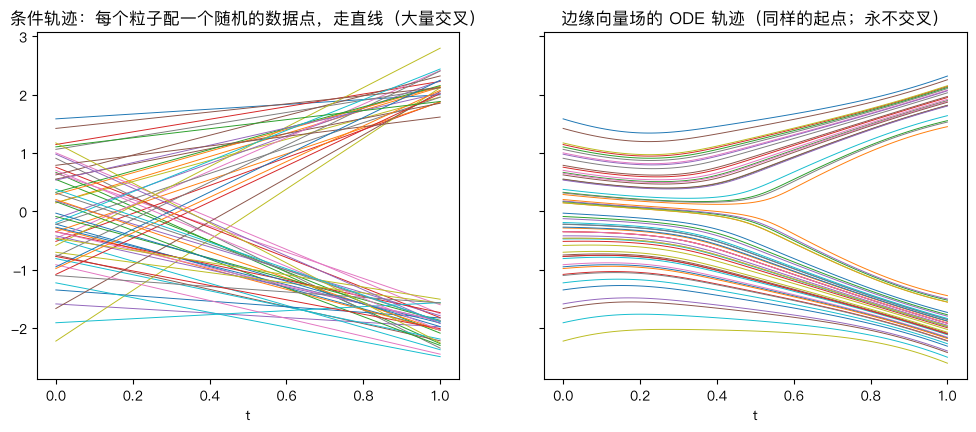
条件直线大量交叉:起点在下面的粒子可能被配到上面的峰。边缘向量场在每个点上把所有”路过这里的条件速度”取平均,相当于把交叉的直线”理顺”成互不相交的曲线(第 1 讲 §2.5:ODE 的轨迹不能交叉)。
3.3 连续性方程
为什么平均以后的向量场恰好沿着 走?证明需要一个基本工具。
定理 11(连续性方程):从 出发的流模型 满足 (对所有 ),当且仅当
直觉(P1 §5.2): 是”概率的流量”(密度 × 速度);散度是单位体积的净流出,负散度就是净流入。左边是某处概率密度随时间的变化率,右边是流入该处的净概率质量。概率总量守恒(积分永远是 1),两边必须相等。P1 §6.3 从”跟着粒子走”的角度推出过同一个方程:。
03 号脚本第 2 部分在 30×30 的网格上用有限差分检验(五峰数据,闭式的 和 ):
| 调度 | 时刻 | 边缘向量场的相对残差 | 把速度放大 10% 后的残差 |
|---|---|---|---|
| CondOT | 0.3 / 0.6 / 0.9 | 1.8e−7 / 3.8e−7 / 5.0e−7 | 0.10 / 0.10 / 0.10 |
| Cosine | 0.3 / 0.6 / 0.9 | 9.5e−8 / 9.9e−8 / 1.7e−7 | 0.10 / 0.10 / 0.10 |
边缘向量场在有限差分的精度内处处满足连续性方程;速度放大 10%,残差立刻变成 10% 量级。
3.4 边缘化技巧的证明
有了连续性方程,证明定理 9 只需验证 满足它。原课讲义的推导只有五步:
(i) 用边缘路径的定义,交换求导和积分;(ii) 每条条件路径各自满足连续性方程(因为 是它的条件向量场);(iii) 散度是对 的线性运算,可以和对 的积分交换;(iv) 乘以再除以 ;(v) 括号里正是边缘向量场的定义。
这个证明的精髓在 (ii)→(iii):连续性方程对向量场是”线性”的(流量 可以叠加)。每条条件路径都守恒,它们的叠加也守恒;而叠加后的总流量除以总密度,就是后验加权平均的速度。
3.5 一个陷阱:有限数据集上的精确解只会背诵
如果把 换成一个有限的训练集 (真实训练的情形),边缘向量场仍然可以精确算出:后验是对 个点的 softmax(gmm_oracle.EmpiricalOracle)。它生成什么?03 号脚本第 4 部分(2000 个噪声起点,欧拉 500 步):
| 训练点数 | 向量场 | 与某个训练点距离 < 0.01 | 到最近训练点的中位距离 |
|---|---|---|---|
| 20 | 训练集上的精确最优场 | 100% | 0.0000 |
| 20 | 真实分布的边缘场(对照) | 0.1% | 0.361 |
| 200 | 训练集上的精确最优场 | 100% | 0.0000 |
| 2000 | 训练集上的精确最优场 | 100% | 0.0000 |
| 2000 | 真实分布的边缘场(对照) | 6.9% | 0.033 |
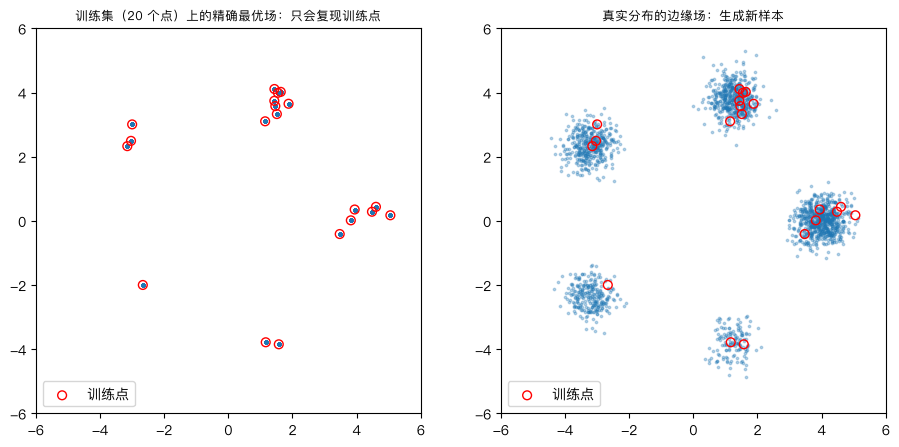
训练集上的精确边缘向量场把每个噪声都送到某一个训练点上:它的边缘路径在 时是”训练点上的 δ 函数之和”,只能复现训练集。§4 会看到,这正是条件流匹配损失在有限数据上的全局最优解。真实的生成模型能产生新样本,恰恰是因为神经网络没有精确学到这个解(§6.3)。
📌 代码 02、03:
python3 02_conditional_vector_fields.py、python3 03_marginalization_trick.py。
4. 损失 · Learning the marginal vector field
4.1 流匹配损失:理想但算不出来
我们想让网络等于边缘向量场。最自然的做法是均方误差,即流匹配损失:
第二个等号用了边缘路径的采样方法。原课讲义的描述是:随机抽一个时间 ,从数据集里抽一个 ,加点噪声得到 ,算网络输出和边缘向量场的均方误差。问题在于 是一个对所有数据的积分,算不出来。
4.2 条件流匹配损失,以及定理 12
把边缘向量场换成条件向量场,就得到条件流匹配损失:
条件向量场有公式,所以这个损失很容易算。可是,对着条件向量场回归有什么意义?我们要的是边缘向量场啊。答案是:
定理 12:,其中 与 无关。因此 ;用随机梯度下降最小化 ,就等价于最小化 。特别地,若网络足够灵活, 的最小值点满足 。
用 P1 的语言,证明只有两行。 记回归目标 (一个随机变量,依赖于 和 ),输入是 。§3.2 刚说过,边缘向量场是 的条件期望:。于是由 P1 §4.3 的均方误差分解:
**对嘈杂的目标做回归,等于对它的条件期望做回归再加一个常数。**条件目标 是”嘈杂但有公式”的,它的条件期望(边缘向量场)是”干净但算不出来”的,而均方误差恰好让两者的梯度相同。原课讲义给的是一个直接展开的证明(把平方展开、交叉项里代入式 (18)、再用积分的线性),本质是同一件事。
这也解释了”条件期望”在这门课里为什么如此重要:只要损失是均方误差,网络学到的就是目标的条件期望,不管目标本身多么嘈杂。第 3 讲的去噪得分匹配会再用一次同样的论证。
4.3 数值验证:常数 C 是多少
04 号脚本第 1 部分在五峰数据、CondOT 路径上,用 20 万个分层样本( 取 100 个等分点)对五个”模型”同时算两个损失:
| 模型 | 差 | ||
|---|---|---|---|
| 零场 | 18.3476 | 11.4959 | 6.8517 |
| 未训练的网络 | 18.4103 | 11.5582 | 6.8521 |
| 训练 200 步 | 8.8243 | 2.0032 | 6.8212 |
| 训练 3000 步 | 6.8977 | 0.0796 | 6.8181 |
| 理想向量场本身 | 6.8184 | 0.0000 | 6.8184 |
直接计算的 (GaussianPathGMMOracle.target_variance 用全方差公式算出每个点的条件方差)。 从 11.5 到 0 相差上百倍,差值却几乎不变(0.5% 以内的出入是抽样误差)。
两个重要推论:
- 条件流匹配损失的最小值不是 0,而是 。理想向量场自己的 。训练曲线停在 附近不再下降是正常的,那是目标里不可约的噪声(P2 §3.3)。
- 损失值几乎不反映模型的好坏。“训练 3000 步”与”理想向量场”的 只差 0.08(1%),而前者生成的样本仍有可见的瑕疵(§5)。
4.4 代价:梯度噪声更大
既然期望相同,用 有什么代价?04 号脚本第 2 部分取”训练 200 步”的网络,先在 20 万个样本上算两个完整梯度:余弦相似度 0.993(相对差 12%,说明即使 20 万个样本,条件目标的梯度噪声也不小)。再看小批量梯度与”真梯度”的余弦相似度(50 次平均):
| 批大小 | 用条件目标() | 用边缘场(,实际中拿不到) |
|---|---|---|
| 64 | 0.192 | 0.281 |
| 256 | 0.313 | 0.539 |
| 1024 | 0.576 | 0.769 |
| 4096 | 0.718 | 0.911 |
同样的批大小下,条件目标的梯度噪声明显更大:目标里多了一份随机性(“这个 究竟来自哪个 ”)。这里用条件目标、批大小 4096 的梯度质量,大致只相当于用边缘场、批大小 1024 的水平。这就是”用能算的目标代替算不出的目标”的代价,也是流匹配常用大批量的原因之一(原课 Lab 2 用 1000)。
4.5 噪声来自哪里:常数 C 随时间的分布
是对 平均的结果。按时刻分开看(04 号脚本第 3 部分),:
| 0 | 0.1 | 0.3 | 0.5 | 0.7 | 0.9 | 0.99 | |
|---|---|---|---|---|---|---|---|
| CondOT | 15.03 | 16.89 | 10.94 | 2.49 | 1.90 | 2.29 | 2.04 |
| Cosine | 37.08 | 31.63 | 12.18 | 3.07 | 2.39 | 4.37 | 4.93 |
以 CondOT 为例: 时 就是噪声 ,完全看不出数据点在哪,目标 的条件方差等于数据的总方差 。 时 ,数据点已经确定,但噪声 看不出来,条件方差趋于 。中间某处最小。所以条件流匹配损失的大部分”地板”来自 接近 0 的那一段,那里的回归目标几乎是纯噪声。很多论文因此对 做非均匀采样或给损失加权(例如 SD3 用”logit-normal”分布把 的采样集中在中间段,第 5 讲会再谈),本质上是在决定把训练的”注意力”分给哪一段时间。
4.6 高斯路径的流匹配,以及 Algorithm 3
把高斯路径的公式代进去,条件流匹配损失变成(原课讲义式 (30)–(31)):
对 CondOT:
原课讲义说:“抽一个数据点、抽一点噪声,然后算一个均方误差。“slides 把这两个量叫”噪声与数据的直线插值”和”数据与噪声之差”。
Algorithm 3  流匹配训练(CondOT 高斯路径)
输入:数据集,神经网络 u^θ
for 每个小批量:
    从数据集抽 z;抽 t ~ Unif[0, 1];抽 ε ~ N(0, I)
    x ← t·z + (1 − t)·ε                    (一般情形:x ~ p_t(·|z))
    L(θ) ← ‖u^θ_t(x) − (z − ε)‖²            (一般情形:‖u^θ_t(x) − u_t(x|z)‖²)
    θ ← 梯度更新(L(θ))
对应的 Python(fm_lib.py,节选):
for step in range(1, steps + 1):
    z = sample_data(batch, g)                            # 数据点
    t = torch.rand(batch, 1, generator=g) * (1 - 1e-4)  # 时间,形状 (n, 1);避开 t = 1
    noise = torch.randn(z.shape, generator=g)            # ε
    x = path.sample_conditional(z, t, noise)             # x_t = α_t z + β_t ε
    target = path.target(z, noise, t)                    # α̇_t z + β̇_t ε(CondOT:z − ε)
    pred = model(x, t)
    assert pred.shape == target.shape                    # P2 §1.2 的广播 bug
    loss = ((pred - target) ** 2).sum(dim=1).mean()
    opt.zero_grad(); loss.backward(); opt.step()
原课讲义列出了这个算法三个”惊人”的特点:
- 不需要模拟(simulation-free):训练时从不模拟 ODE,也不需要散度和行列式(对比 §1 的最大似然)。
- 就是回归:和监督学习没什么两样,只是目标带噪声。
- 极其简单:很难想象比这更简单的训练目标。
原课讲义提到,Stable Diffusion 3、Meta Movie Gen 等模型都是用这个简单的过程训练的。训练好以后,用第 1 讲的 Algorithm 1 采样即可。整套流程在文献里叫流匹配(flow matching)。
📌 代码 04:
python3 04_fm_vs_cfm_loss.py。
5. 实验:训练一个流匹配模型 · Training
5.1 训练过程:看样本,不要看损失
05 号脚本第 1 部分按原课 Lab 2 的设置训练:4 个 64 宽的隐藏层(SiLU),5000 步,批大小 1000,Adam、学习率 ,五峰数据,CondOT 路径。每 500 步记录训练损失、真实误差 (只因数据分布已知才能算)和生成样本的质量(欧拉 100 步):
| 步数 | 训练损失 | 减去下限 C | 样本能量距离 | 权重误差 TV | 落在峰之间 | |
|---|---|---|---|---|---|---|
| 500 | 8.807 | +1.987 | 0.474 | 0.0101 | 0.048 | 2.5% |
| 1000 | 7.084 | +0.264 | 0.166 | 0.0090 | 0.030 | 1.1% |
| 2000 | 6.928 | +0.108 | 0.092 | 0.0022 | 0.042 | 0.8% |
| 3000 | 6.917 | +0.097 | 0.077 | 0.0033 | 0.021 | 0.5% |
| 4000 | 6.871 | +0.051 | 0.069 | 0.0026 | 0.022 | 0.3% |
| 5000 | 6.890 | +0.070 | 0.037 | 0.0002 | 0.033 | 0.6% |
训练只用了约 5 秒。训练损失很快贴近下限 ,之后在 +0.05 到 +0.1 之间随批量噪声上下波动;真实误差 却一直在下降(0.47 → 0.037)。样本指标的变化更”粗”:能量距离在 1500 步后就进入噪声地板,权重误差在 0.01–0.04 之间波动,“落在峰之间”的比例从 2.5% 缓慢降到约 0.5%。
实践中怎样判断训练进度? 真实问题里 算不出来,损失又几乎不动,所以只能定期生成样本,用合适的指标(图像上常用 FID 等)去评估。这是训练扩散 / 流模型时的普遍做法。
5.2 训练好的网络 vs 理想向量场
05 号脚本第 2 部分让网络和理想场从同一批噪声出发,比较不同步数(能量距离 / 权重误差 / 落在峰之间):
| 欧拉步数 | 网络 | 理想向量场 |
|---|---|---|
| 1 | 2.541 / 0.709 / 100% | 2.775 / 0.750 / 100% |
| 4 | 0.078 / 0.063 / 7.1% | 0.081 / 0.081 / 2.7% |
| 16 | 0.0031 / 0.029 / 0.9% | 0.0016 / 0.025 / 0.1% |
| 100 | −0.0006 / 0.033 / 0.2% | −0.0023 / 0.021 / 0.0% |
步数够多时,网络样本的能量距离也在噪声地板以内;同一个噪声起点,网络与理想场的终点距离中位数只有 0.066(峰的标准差是 0.4)。但细看仍略差:权重误差 0.033 vs 0.021,峰之间 0.2% vs 0.0%。步数很少时,两者一样塌缩、模糊(第 1 讲 §3.6),少步误差主要由 ODE 本身的弯曲决定。( 时网络没有完全塌缩到 ,因为它在 处学到的场和 有偏差。)
5.3 网络在哪个时间段学得最差
05 号脚本第 3 部分按时刻分开算 :
| 0 | 0.2 | 0.4 | 0.6 | 0.8 | 0.99 | |
|---|---|---|---|---|---|---|
| 均方误差 | 0.065 | 0.024 | 0.029 | 0.047 | 0.034 | 0.093 |
| 相对误差 | 1.97% | 0.84% | 0.23% | 0.28% | 0.21% | 0.57% |
相对误差在两端最大。 处的理想场只是线性的 ,按理最好学,但那里回归目标最吵(§4.5:,全程最大),网络对一个很吵的目标做回归,估计误差自然最大。 时理想场在峰附近变化剧烈(每个峰都在”收紧”),绝对误差也变大。中段反而最准。“哪一段时间最难”取决于用什么衡量,这也是”怎样分配 的采样”会成为一个设计问题的原因。
5.4 没有闭式解的数据
05 号脚本第 4 部分不改任何超参数,在原课 Lab 2 的另外三个数据集上训练(能量距离;噪声地板是两批真样本之间的距离):
| 数据 | 生成样本 | 噪声地板 | 对照:纯噪声 |
|---|---|---|---|
| 双月牙 | −0.0012 | −0.0011 | 0.758 |
| 棋盘格 | 0.0035 | +0.0016 | 1.066 |
| 同心圆 | 0.0005 | −0.0013 | 0.995 |
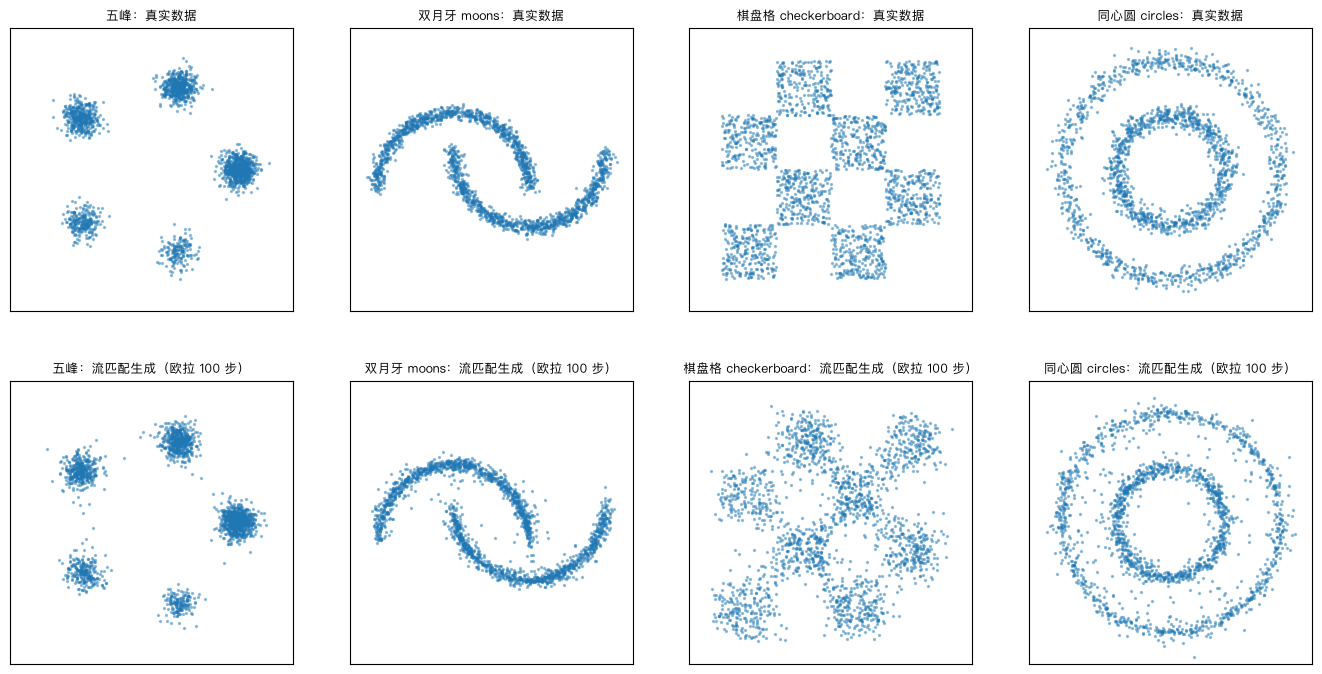
同一套代码就能学会这些形状:流匹配只需要数据样本。双月牙、同心圆的能量距离在噪声地板以内;棋盘格略高。但能量距离对”尖锐的边”不敏感:棋盘格的生成样本有 15.1% 落在白格或方块外(真实数据是 0%),图上方块被抹成了圆团。这个小网络、5000 步学不出锐利的边界(练习 6 看更长的训练)。一个教训:评估生成模型时,单一的分布指标往往不够,要结合问题本身的结构去看。
📌 代码 05:
python3 05_train_flow_matching.py(约 20 秒;--quick是几秒钟的冒烟测试)。
6. 推广与局限 · Extensions and caveats
6.1 任意分布之间的搭桥
推导流匹配时,我们从没用到” 是高斯”。原课 Lab 2 第 4 部分的线性路径:
条件向量场 ,回归目标就是 。只要能从两个分布各自采样,就能在它们之间训练一个流。06 号脚本第 1 部分让同心圆直接”流”成双月牙:
| 起点分布 | 与双月牙的能量距离 |
|---|---|
| 同心圆(线性路径) | 0.0025 |
| (CondOT 高斯路径,对照) | 0.0029 |
| 噪声地板 | −0.0016 |
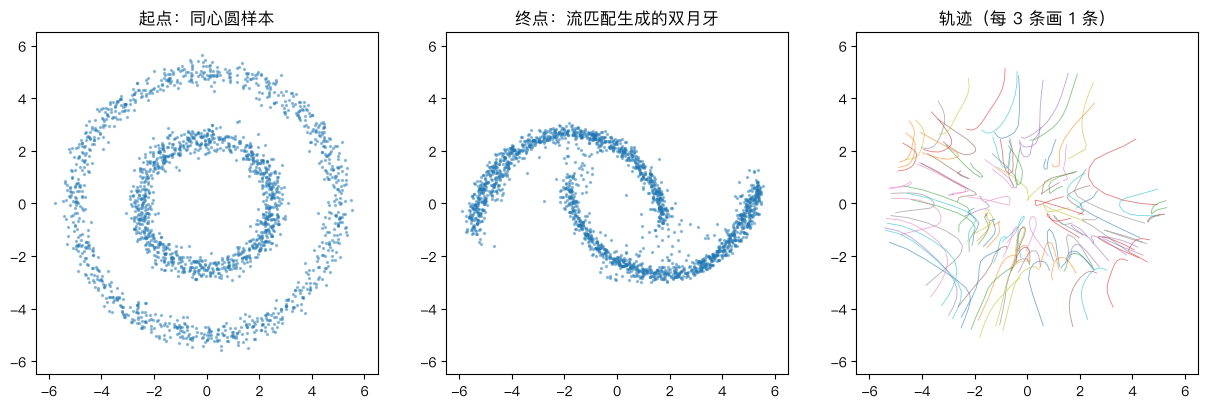
原课 Lecture 3 的 slides 举了几个应用:无声视频 → 有声视频、低分辨率图像 → 高分辨率图像、未扰动的细胞 → 扰动后的细胞。高斯起点的特殊之处只在于:它的条件路径有得分函数的公式(第 3 讲需要),而且对称、容易采样。
6.2 调度的选择:没有一个放之四海而皆准的答案
一个常见的说法是:“CondOT 的轨迹最直,所以少步采样最好;这是 SD3 选择 rectified flow 的原因。“我们在玩具数据上检验了这个说法,结果并不支持它。
先用理想边缘向量场比较(排除训练误差,06 号脚本第 2 部分):
| 调度 | 路径长度/直线距离(中位数) | 最大速度(中位数) | ||||
|---|---|---|---|---|---|---|
| CondOT | 1.0495 | 4.4 | 0.551 | 0.087 | 0.021 | 0.0035 |
| SqrtBeta | 1.0432 | 4.1 | 0.418 | 0.074 | 0.017 | 0.0034 |
| Cosine | 1.0435 | 5.0 | 0.329 | 0.066 | 0.018 | 0.0039 |
(后四列是欧拉 步样本的能量距离。)在这份数据上,CondOT 的边缘轨迹反而略弯一些,少步()的质量也略差。SqrtBeta 的条件轨迹在终点速度暴增(§3.1),边缘轨迹却很平稳。三者的差别其实都不大(路径长度只差约 0.6%, 后几乎相同)。再看训练出来的网络(第 3 部分;能量距离 / TV / 峰之间):
| 调度 | |||
|---|---|---|---|
| CondOT | 0.111 / 0.088 / 8.2% | 0.033 / 0.043 / 2.1% | 0.0086 / 0.021 / 0.5% |
| SqrtBeta | 0.080 / 0.056 / 13.8% | 0.021 / 0.036 / 4.7% | 0.0039 / 0.022 / 0.8% |
| Cosine | 0.099 / 0.097 / 7.2% | 0.039 / 0.056 / 2.5% | 0.014 / 0.034 / 0.7% |
没有一致的赢家: 时 SqrtBeta 的能量距离最小、落在峰之间的样本却最多;不同指标给出不同的排序。练习 7 还表明,把数据缩放到不同的尺度,排序会再变。
怎样理解?
- “条件轨迹是直线”不等于”边缘轨迹是直线”。 CondOT 保证的是每一条条件轨迹是直线;边缘轨迹是它们的后验平均,弯不弯取决于数据分布本身(粒子要先”决定”去哪个峰)。
- 调度的优劣要在真实数据上用大规模实验判断。 SD3 的论文(Esser et al., 2024)在图像上系统比较了多种路径与时间采样方式,报告 rectified flow(即 CondOT)配合非均匀的时间采样整体表现最好。那是在高维图像、大模型上的经验结论,不是一个对所有数据都成立的定理。二维玩具上的结果不能直接推广到图像,反过来也一样。
6.3 训练出来的网络会背诵吗?
§3.5 说,有限训练集上的精确最优解只会复现训练点。那么用这 20 个训练点训练一个网络(06 号脚本第 4 部分),它生成什么?
| 生成方式 | 离某个训练点 < 0.05 | 到最近训练点的中位距离 |
|---|---|---|
| 训练集上的精确最优场 | 100% | 0.000 |
| 网络,训练 5000 步 | 7.4% | 0.155 |
| 网络,训练 20000 步 | 47.8% | 0.053 |
| 真实分布的边缘场(对照) | 2.3% | 0.336 |
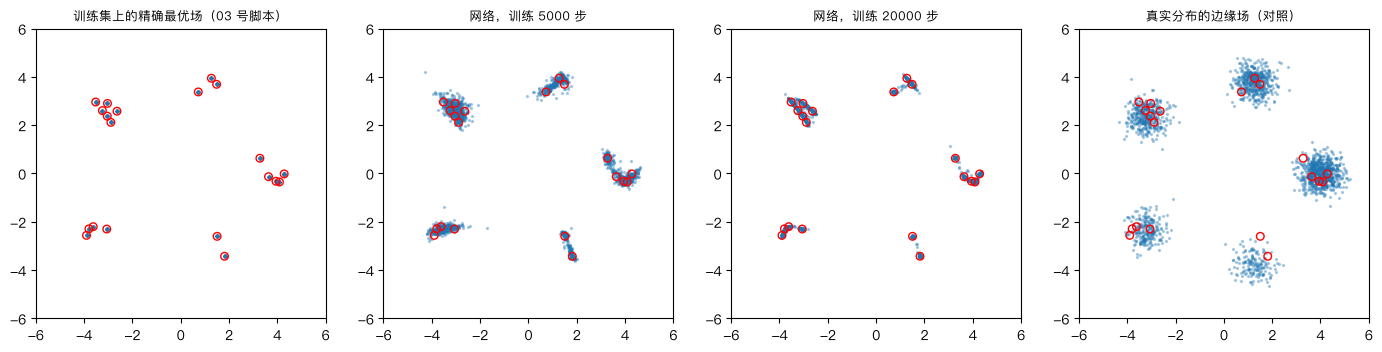
网络介于两者之间:它的样本明显向训练点聚拢。5000 步时,样本铺在相邻训练点之间的连线上,像是在训练点之间”插值”;训练到 20000 步时,近一半样本离某个训练点不到 0.05,网络在一点点逼近那个”背诵”的最优解。
这个现象在大规模扩散模型上也被观察到:训练数据越少、训练越久,越容易复现训练图像(Somepalli et al., 2023;Carlini et al., 2023)。反过来说,扩散 / 流模型能生成新样本,靠的是网络学不准那个精确最优解:容量有限、训练有限、神经网络倾向于光滑的函数。为什么”学不准”恰好产生了”好的新样本”,是一个活跃的研究问题。
📌 代码 06:
python3 06_bridging_and_schedules.py(约 50 秒;--quick是几秒钟的冒烟测试)。
7. 全景 · The big picture
7.1 原课的总结(Summary 14)
流匹配训练的是边缘向量场 。构造它的步骤:
- 选一条条件概率路径 ,满足 、;
- 找一个条件向量场 ,它的流把 变成 (等价地:满足连续性方程);
- 边缘向量场 沿边缘路径走,把噪声变成数据;
- 最小化条件流匹配损失 来学习它。
对高斯路径:
7.2 文献里的名字
同一个想法在 2022–2023 年被几组人独立提出,名字不同:
| 名字 | 论文 | 在本讲的语言里 |
|---|---|---|
| Flow Matching / Conditional Flow Matching | Lipman et al., ICLR 2023 | 本讲的框架;“CondOT”路径 |
| Rectified Flow | Liu, Gong & Liu, ICLR 2023 | CondOT 路径(直线插值)+ 训练 ;另有”reflow”把轨迹拉直(扩展讲第 7 讲) |
| Stochastic Interpolants | Albergo & Vanden-Eijnden, ICLR 2023 | 用”插值函数” 构造路径,包含 ODE 和 SDE 两种走法;与本讲大体等价 |
| Denoising Diffusion(DDPM 等) | Ho et al., 2020;Song et al., 2021 | 某些高斯路径(方差保持 / 方差爆炸)+ 预测噪声或得分;第 3 讲会对照 |
原课讲义附录 E 的说法是:对高斯路径,这些框架本质上是等价的;流匹配的优点在于简单和通用(任意 ,任意路径)。
8. 小结 · Summary
- 问题:没有现成的”正确向量场”,最大似然又太贵。流匹配先设计概率路径,再反推向量场,最后用回归学它。
- 概率路径:条件路径 从噪声收缩到一个数据点;边缘路径 从噪声插值到数据,能采样、算不出密度。高斯路径 由调度决定;概率路径只规定快照,不唯一确定向量场。
- 条件向量场 ;在 处等于 (CondOT:)。
- 边缘化技巧:边缘向量场 = 条件向量场按后验加权平均 = ,它沿边缘路径走。证明靠连续性方程和它对流量的线性。边缘轨迹不交叉,是交叉的条件轨迹的”理顺”版本。
- 定理 12:,。梯度相同,但条件目标的梯度噪声更大;损失的最小值是 而不是 0,大部分来自 接近 0 的那一段。
- Algorithm 3:抽 、、 → → 回归 。不模拟 ODE、就是回归、极其简单。评估要看样本,不看损失。
- 推广与局限:线性路径能在任意两个分布之间搭桥;调度的优劣没有普适答案;有限数据上的精确最优解只会背诵训练集,训练出来的网络介于背诵与泛化之间,训练越久越靠近背诵。
9. 常见误区 · Common pitfalls
- “条件流匹配学到的是条件向量场。” 网络的输入里没有 ,它看到的只是 和 。用均方误差回归,它学到的是条件目标在给定 时的条件期望——边缘向量场(§4.2)。
- “训练损失降不到 0,说明模型或代码有问题。” 损失的最小值是 (本讲的例子里约 6.82),而且损失值几乎不反映模型质量(§4.3、§5.1)。
- “CondOT 的生成轨迹是直线。” 条件轨迹是直线;生成时走的边缘轨迹一般是曲线(§6.2)。
- “流匹配训练时要模拟 ODE。” 训练时完全不模拟;只有采样时才模拟(§4.6)。
- “边缘概率路径确定了向量场。” 同一条路径可以由无穷多个向量场实现,例如加上一个沿等高线的旋转场(§2.4)。
- ” 必须是高斯。” 对线性路径,任何能采样的分布都可以(§6.1)。高斯的好处是条件得分有公式(第 3 讲)。
- “把损失训练到最低就是最好的模型。” 在有限数据上, 的全局最优解只会背诵训练集(§3.5、§6.3)。
- “时间 写成
(n,)也一样。” 和(n, d)的张量相乘时可能触发广播 bug(P2 §1.2)。本讲的代码统一用(n, 1)并加了assert。
10. 练习 · Exercises
练习 1(条件向量场)。对 Cosine 调度 、,写出 和回归目标 。验证在 处 。
参考答案
,,。所以 。回归目标 。 时 :一开始粒子朝 的方向出发,与位置无关。
练习 2(边缘向量场的两个端点)。对 CondOT 路径,证明 ,(假设数据分布有密度)。用第 1 讲 §3.6 的结论解释 的含义。
参考答案
。 时 , 与 独立,所以 :一开始所有粒子都朝数据的均值走(欧拉法一步就塌缩到 )。 时 , 与 独立,:终点处的速度就是位置本身(“沿着从原点出发的射线继续向外”,因为 在 时的速度 平均来看就是 )。
练习 3(定理 12 的直接证明)。仿照 §4.2,用 P1 §4.3 的分解证明:,其中 。它为什么一定非负?什么时候等于 0?
参考答案
由分解,差 ,而条件方差 ,后者就是 。方差非负;等于 0 当且仅当几乎处处 由 唯一确定,例如数据分布是单个点 时(那时 唯一确定 )。
练习 4(线性路径)。对线性路径 ,验证 是条件向量场,并说明 时它就是 CondOT 高斯路径。
参考答案
条件流 ,对 求导得 ;把 代入:。若 ,则 ,正是 、 的高斯路径;代入式 (20):,一致。
练习 5(梯度噪声与批大小)。§4.4 的表里,条件目标需要大约多大的批,才能达到边缘目标批大小 256 时的梯度质量?粗略地用”余弦相似度 ≈ ”( 是单样本梯度的方差之和)解释这个现象。
参考答案(提示)
边缘目标 时余弦 0.54;条件目标在 时 0.58,所以大约需要 4 倍的批。按公式,余弦由”噪声 / 信号”比 决定;条件目标的单样本方差 更大(多了”来自哪个 “的随机性),要达到同样的余弦, 要按 的比例放大。
练习 6(编程:更长的训练)。在 05_train_flow_matching.py 第 4 部分里,把棋盘格的训练步数改成 20000,再试一次把 make_model 的 hidden 改成 128。“落在白格或方块外”的比例怎样变化?
参考答案(作者机器上的结果)
5000 步、64 宽:15.1%;20000 步、64 宽:约 8.2%(能量距离 0.0022);20000 步、128 宽:约 6.8%(能量距离 0.0024)。训练更久、网络更宽都能让边界更锐利,但能量距离几乎看不出这种改进——再次说明要结合问题本身的结构来评估。(128 宽、20000 步约需 35 秒。)
练习 7(编程:数据的尺度与调度)。把 06_bridging_and_schedules.py 第 2 部分的数据换成 GaussianMixture.ring(5, radius=R, std=R/10, weights=[...]),分别取 ,比较三种调度的路径长度比和 时的能量距离(除以 以便比较)。排序会随 变化吗?
参考答案(作者机器上的结果,300 条轨迹、500 步)
| 路径长度比 CondOT / SqrtBeta / Cosine | 能量距离 / | |
|---|---|---|
| 1 | 1.430 / 1.149 / 1.126 | 0.020 / 0.038 / 0.007 |
| 2 | 1.318 / 1.171 / 1.191 | 0.014 / 0.020 / 0.008 |
| 4 | 1.049 / 1.039 / 1.045 | 0.026 / 0.022 / 0.018 |
| 8 | 1.015 / 1.014 / 1.013 | 0.081 / 0.063 / 0.079 |
排序随尺度变化: 时 Cosine 的少步质量明显最好, 时 SqrtBeta 最好;CondOT 在这几种尺度上都不是最好的。一个可能的解释是:数据离原点近时( 小),起点(半径约 1.25 的噪声)和终点(半径 )离得不远,“先拐弯决定去哪个峰”在路径长度里占的比例更大。无论原因如何,结论是调度的优劣和数据的尺度纠缠在一起——这也是实践中要把数据标准化(或调整噪声的尺度)的原因之一。
练习 8(思考:为什么不学条件向量场的”条件版本”?)。如果给网络多一个输入 ,让它学 ,能用来生成吗?
参考答案
不能(或者说没有意义):生成时你要先有一个 才能用这个网络,而 正是我们想生成的东西;而且 有公式,根本不需要学。流匹配的妙处在于网络看不到 ,只能输出”在所有可能的 上的平均”,而这个平均恰好是能把噪声变成数据的边缘向量场。(第 4 讲的条件生成是另一回事:那里的条件是标签 / 提示 ,不是数据点 。)
11. 延伸阅读 · Further reading
- 原课讲义第 3 章和 Lab 2(https://github.com/eje24/iap-diffusion-labs ,2026 分支)。Lab 2 用 SqrtBeta 路径实现条件路径、条件向量场和训练,并在第 4 部分做线性路径的搭桥。
- Lipman et al., Flow Matching for Generative Modeling(ICLR 2023):提出(条件)流匹配,比较了 OT 路径和扩散路径。
- Liu, Gong & Liu, Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow(ICLR 2023):直线插值 + reflow。
- Albergo & Vanden-Eijnden, Building Normalizing Flows with Stochastic Interpolants(ICLR 2023);以及 Albergo, Boffi & Vanden-Eijnden, Stochastic Interpolants: A Unifying Framework for Flows and Diffusions(2023)。
- Lipman et al., Flow Matching Guide and Code(2024,arXiv:2412.06264):系统的教程,配开源库
flow_matching。 - Esser et al., Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(SD3 论文,ICML 2024):在图像上大规模比较路径与时间采样方式。
- 记忆与泛化:Somepalli et al., Diffusion Art or Digital Forgery?(CVPR 2023);Carlini et al., Extracting Training Data from Diffusion Models(USENIX Security 2023);以及一系列用”经验最优解会背诵”出发分析扩散模型泛化的近期论文。
- 交互式可视化:https://mariogemoll.com/flow-matching (slides 里条件 / 边缘路径的动画来自这里)。
12. 下一讲预告 · Next lecture
本讲只用了 ODE。第 1 讲 §5.4 的预告实验表明:给流模型加噪声需要一个修正项 ,其中 是边缘路径的得分函数。第 3 讲要回答:
- 得分函数也能像向量场一样,用”条件得分”的回归学出来吗?——去噪得分匹配,这就是”去噪扩散模型”名字的由来。
- 对高斯路径,学会向量场和学会得分函数是不是一回事?——一个简单的换算公式说”是”。
- 为什么加了修正项的 SDE 对任意 都沿着 走?——Fokker–Planck 方程:连续性方程 + 热方程(P1 §5.3)。
- 文献里的 DDPM、DDIM、“前向过程”、“时间反演”,怎样对应到本讲的概率路径?